




软件

产品


深度Q网络(Deep Q-Network,DQN)是一种结合了深度学习和Q学习的强化学习算法,由DeepMind在2015年提出。
DQN算法通过使用深度神经网络来近似Q值函数,解决了传统Q-learning在处理具有大量状态和动作的复杂问题时的局限性。在DQN中,神经网络的输入是环境的状态,输出是对应于各个可能动作的Q值。
状态(State):智能体在每个时间步观察到的环境当前状态。
动作(Action):智能体在每个时间步选择的动作,以影响环境并获取奖励。
奖励(Reward):智能体执行动作后从环境中获得的反馈,用于指导学习过程。
经验回放(Experience Replay):DQN会将智能体的经验(状态、动作、奖励、新状态)存储在一个数据集中,然后从中随机抽取样本进行学习,以打破数据之间的相关性并提高学习效率。
目标网络(Target Network):DQN引入一个目标网络来稳定学习过程。目标网络定期从主网络复制参数,用以计算一个更加稳定的Q值估计,有助于缓解学习过程中的不稳定性和过度估计的问题。
损失函数(Loss Function):DQN的损失函数基于均方误差(MSE)来计算预测Q值与目标Q值之间的差异,通过梯度下降等优化算法来最小化这个损失函数,从而更新Q网络的参数。
初始化:初始化经验池,随机初始化Q网络的参数,并初始化目标网络,其参数与Q网络相同。
获取初始状态:智能体从环境中获取初始状态。
选择动作:智能体根据当前状态和ε-贪心策略选择动作。
执行动作并观察:智能体执行动作并观察新的状态和获得的奖励。
存储经验:将经验(状态、动作、奖励、新状态)存储在经验池中。
样本抽取与学习:从经验池中随机抽取样本,并使用这些样本来更新Q网络。
目标网络更新:定期将Q网络的参数复制到目标网络。
DQN通过引入目标网络和经验回放机制,提高了模型的稳定性和性能。这些机制有助于减少学习过程中的不稳定性,使得DQN能够在复杂环境中学习有效的策略。
6.1基本原理
状态空间:在路径规划问题中,状态通常表示为机器人当前的位置或状态,以及与目标位置的关系。
动作空间:动作空间定义了机器人可以采取的所有可能的动作,如移动到相邻的位置。
奖励函数:奖励函数定义了机器人在执行动作后获得的即时奖励。在路径规划中,奖励可以设置为负的移动成本或与目标位置的接近程度。
Q值函数:Q值函数评估在给定状态下采取特定动作的期望累积奖励。DQN使用深度神经网络来近似Q值函数。
6.2算法步骤
环境设置:定义路径规划问题的环境,包括状态空间、动作空间、奖励函数等。
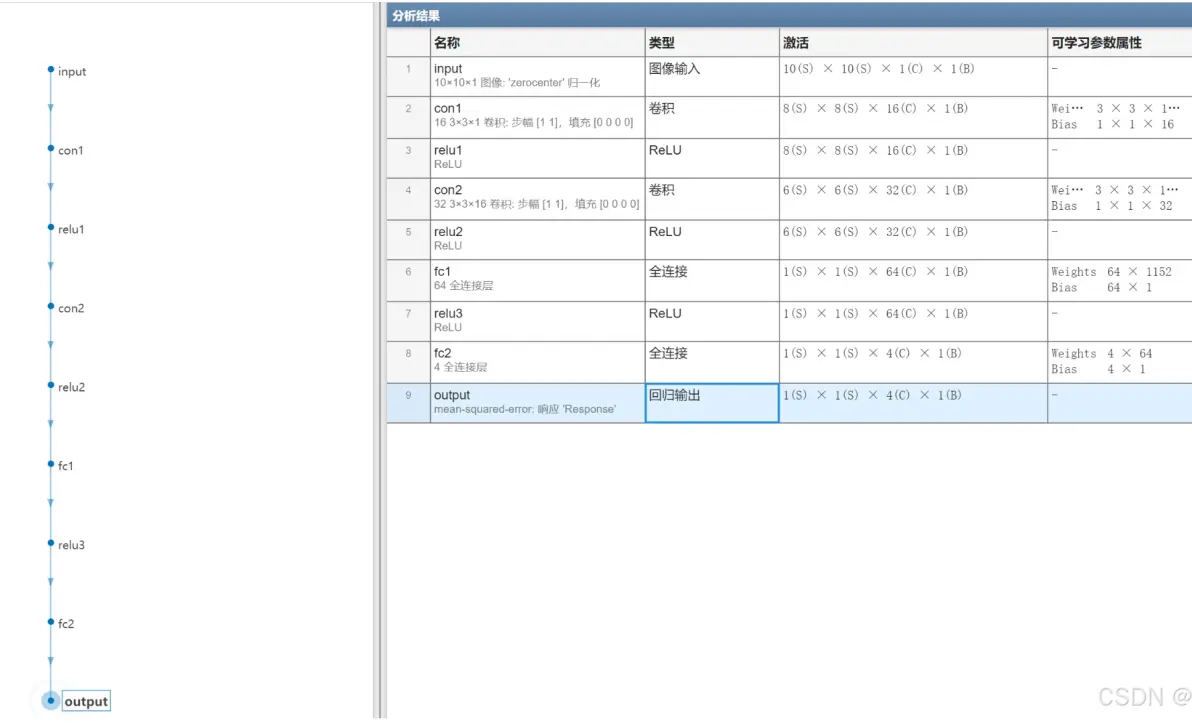
DQN网络设计:设计一个深度神经网络作为Q值函数的近似。网络输入是状态,输出是动作的Q值。
训练:使用DQN算法训练网络。在训练过程中,机器人与环境交互,收集经验,并通过经验回放更新网络。
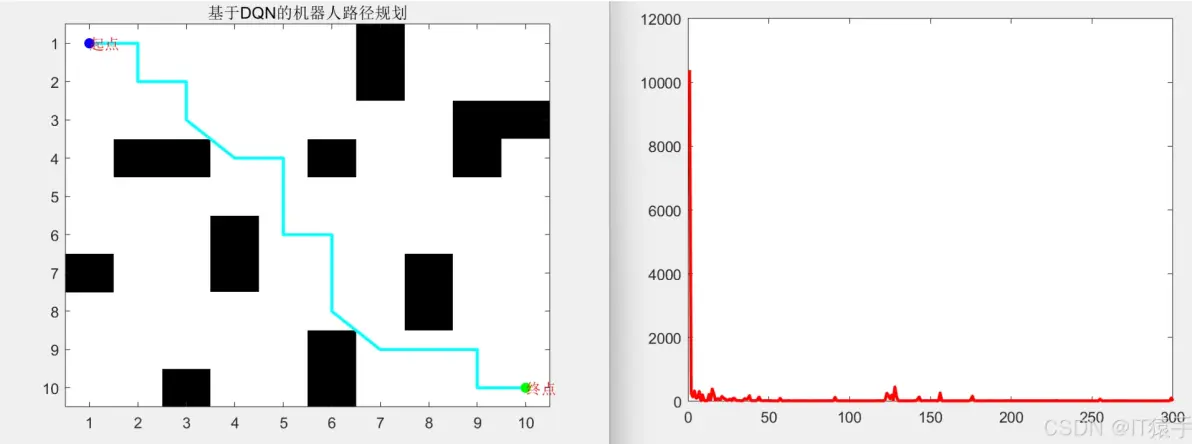
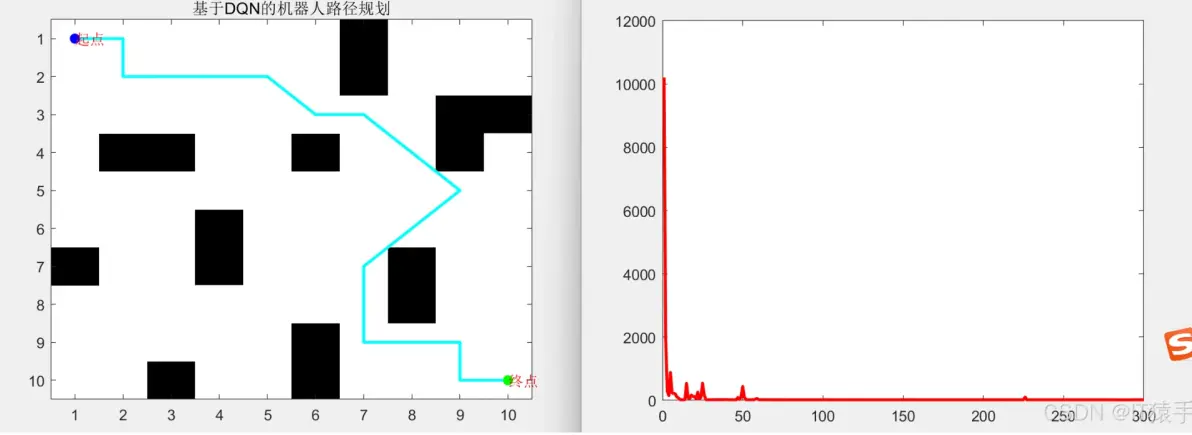
路径规划:在训练完成后,使用训练好的DQN网络来规划路径。机器人根据当前状态和Q值函数选择最优动作,逐步接近目标位置。
代码块
JavaScript
自动换行
复制代码
123456789101112131415161718192021222324252627
%% 画图

figure

plot(curve,'r-',LineWidth=2);


figure

imagesc(~map)

hold on

plot(state_mark(:,2),state_mark(:,1),'c-',LineWidth=2);

colormap('gray')

scatter(start_state_pos(2) ,start_state_pos(1),'MarkerEdgeColor',[0 0 1],'MarkerFaceColor',[0 0 1], 'LineWidth',1);%start point

scatter(target_state_pos(2),target_state_pos(1),'MarkerEdgeColor',[0 1 0],'MarkerFaceColor',[0 1 0], 'LineWidth',1);%goal point

text(start_state_pos(2),start_state_pos(1),'起点','Color','red','FontSize',10);%显示start字符

text(target_state_pos(2),target_state_pos(1),'终点','Color','red','FontSize',10);%显示goal字符

title('基于DQN的机器人路径规划')

      复制成功
DQN的结构图:
原文链接:https://blog.csdn.net/weixin_46204734/article/details/144486982
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文





 155-2731-8020




