




软件

产品


在我之前实现时缓效果时,一直是“降调不降速”——因为我的时间速率为0.25,之前试过直接设置audio source的pitch,值为0.25时非常奇怪,而且音量几乎消失了;所有后来改成了修改audio mixer中pitch shifter中的"pitch",达成了一个暂时可以接受的效果。之前我也一直没有深究pitch shifter中的"pitch"和audio mixer的pitch有什么区别,和为什么分别会有不同的效果;现在需要改成一个更符合时缓特征的慢速效果——
于是不得不从原理上好好琢磨以下,特别是关于音量,音调,还有被AI忽悠的所谓“能量守恒”。
初高中物理说,“音量只跟振幅有关,跟频率无关”。问题是这句话有非常大的模糊点。我们之所以能听到某个声音,是因为它一直在振动,如果它静止,即使处在振幅高点,也根本不会有音量;但另一方面,我们显然听过音量非常高的低音音乐,音量能够高于普通的高音音乐,所以说跟频率无关也是对的。
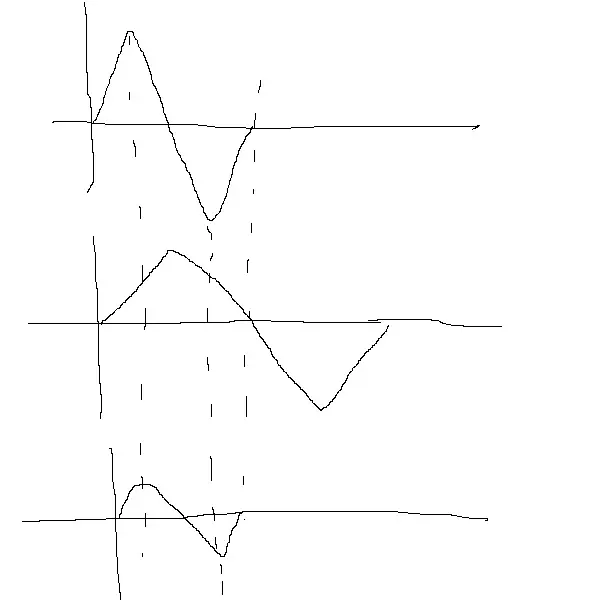
究其本质,“一个”音之所以被我们听到,是空气振动的一个脉冲在我们的鼓膜上形成了一个压力脉冲,进而进入大脑成为脉冲信号。那音量是什么,振动位移量?速度?那不是频率了吗?另外,如果现在有一个理想不间断的“空气冲击波发生源”一直在向外产生空气压力,我们的鼓膜虽然没有产生振动,但是长时间处于被压力弯曲的状态,这时候到底算有无音量?
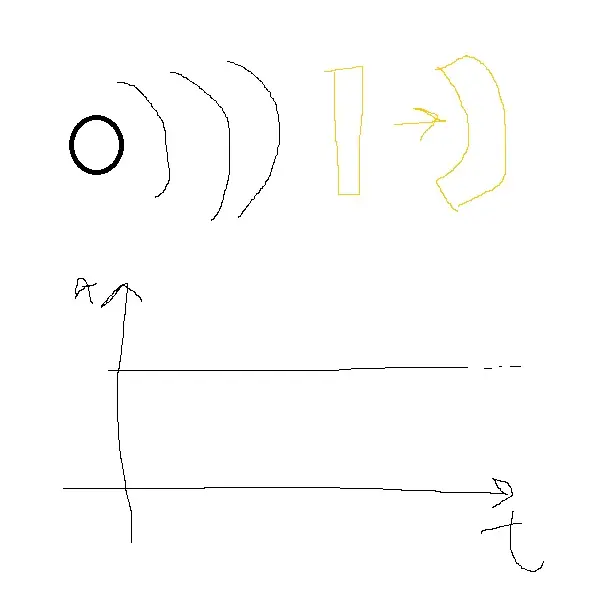
在这种情况下,一个更好的理解模型是丢弃鼓膜振动,脑电脉冲概念,而是把耳朵抽象成一个“理想电子压力计”,只要外部有压力,那就认为有音量。这样,音量就和振动的概念分离开来,与时间分离开来,“音量只与振幅有关”这句话也能成立了——即使振动位置x处于静止,但x!=0表明鼓膜仍然处于压力状态,可以被视作有音量。
以x-t图像为例,慢放2倍,很容易看出慢放会导致频率为原来的0.5倍,而播放时长为原来的2倍。
然而数码播放的采样率是有限的,假设前后采样率一致,在一些情况下,很容易看出慢放的振幅(音量)高点被忽略了:
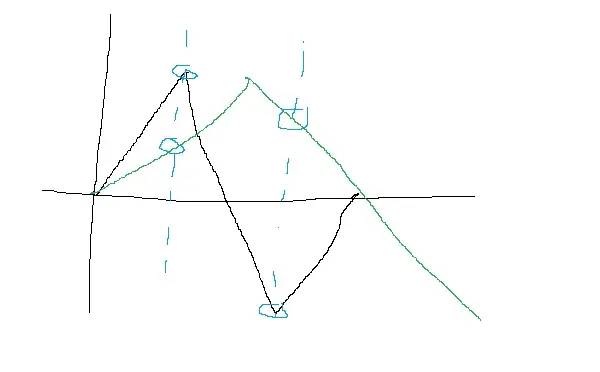
当情况更极端,有“奈奎斯特采样定理”,我称之为“二倍失真定理”(理想低通信道的最高大码元传输速率B=2W,信息传输速率C=B*log2N )。
所以AudioMixer的PitchShifter中的pitch会装模做样地把“pitch”限制为0.5到1,实际并不是真实pitch,它只是把原pitch左右移动了一个非常小的系数,所以我原来的效果听起来几乎就没有慢速,但是达成了低频的效果(但这个低频效果还需要其他技术才能实现得这么明显)。
上面已经阐述,由于我以前0.25的慢放实在是太慢,导致采样失真,会丢失许多音量。(武士零中,控制音效pitch最小为0.5,即使时缓比如为0.3)。另一方面,人耳对不同频率(Hz)的感知音量不一致,低频会感觉音量更小,所以需要根据频率做音量增大。(一些音乐播放器的“个人耳纹调校”功能也就是这个)
当我一开始询问AI为什么慢放会导致音量变小时,AI说“由于能量守恒,慢放播放时间变长,那么相同时间内音量就小”。貌似有理,一派胡言。之前我们已经明晰过【音量】这个概念,只是振幅位置而非移动距离,所以我们体感音量是一个积分过程。好比一个举重运动员举重1s和举重1000s,我们的总体感知量肯定是后者大。
音频变速不变调这里就不说了,网上有很多。而完美的“降调不降速”是不可能的,只是因为PitchShifter中的“pitch”对真实的pitch(audioSource.pitch)改变得很少,而且通过FFT转频域控制和适当修改相位和其他技巧,能够在不改播放时长太多的情况下,实现更显著的降调。
音频慢放似乎简单,但是要做舒服也需要一些调整。除了技术之外,最重要的是从审美上控制整个缩放范围的表达,就像图片一样,原大小图片和同相框的缩放后图片完全不是一个东西。
就unity来说,想要“变调不变速“,只使用mixer的pitchShifter的shift;想要做正常的慢放效果,改变AudioSource.pitch,最好控制其在0.5以上。而且不管哪种,都最好做音量补偿。(本文没有讨论”变速不变调“,在Unity中,应该需要额外算法或插件)
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文





 155-2731-8020




