




软件

产品


原标题:《明日方舟:终末地》如何用 Unity 流畅实现开放场景与工厂系统
原报道作者:Seoho Ruudi Yoon(윤서호) 2026年7月21日
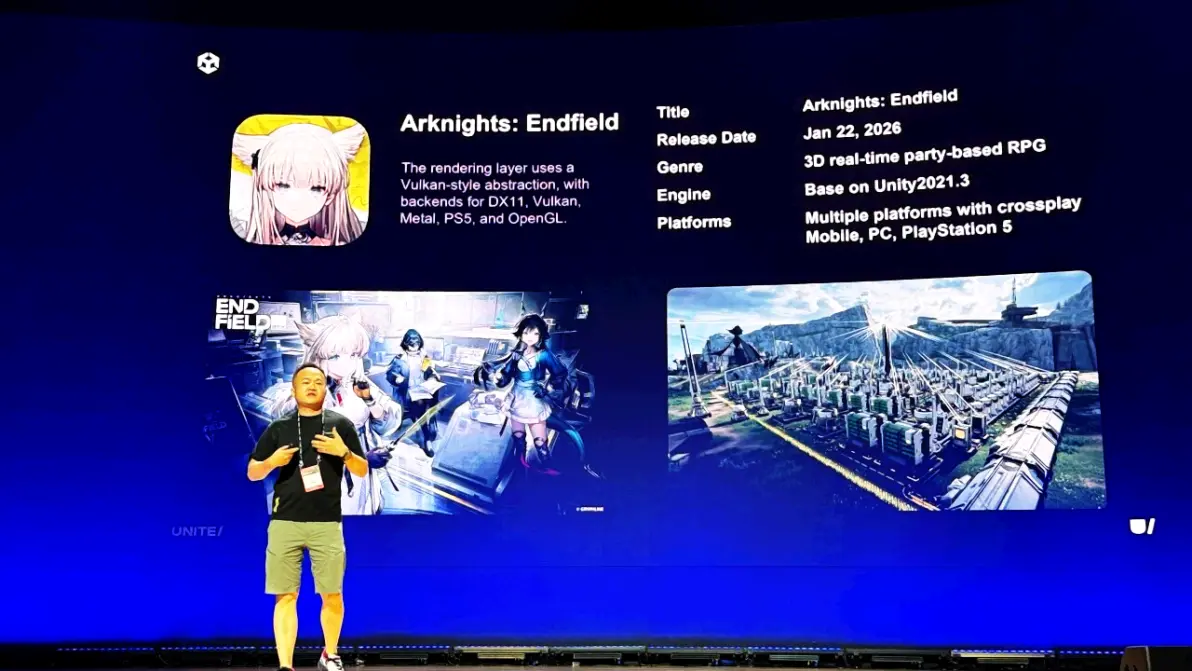
7月21日,Unity 在首尔 COEX 大宴会厅举办了开发者大会 Unite Seoul 2026。Unity引擎第7代 在此次大会上首次面向全球公开,来自世界各地的 Unity 开发者也齐聚现场,分享各自的技术经验。其中一个重点项目是于1月22日上线的《明日方舟:终末地》。游戏既有高密度的开放场景,也有让玩家建造并扩展各类工业设施的工厂系统。开发团队采用 NPR(non-photorealistic rendering,非真实感渲染)与 PBR(physically based rendering,基于物理的渲染)相结合的混合方案,在维持高画质的同时,让游戏能够在主机、PC 和移动设备上流畅运行。
《明日方舟:终末地》的开发团队是如何做到这一点的?Hypergryph 高级技术总监 Honghui Fei 在 Unite Seoul 2026 的演讲中介绍了相关开发过程。
借助 ECS 最大化缓存友好的内存布局
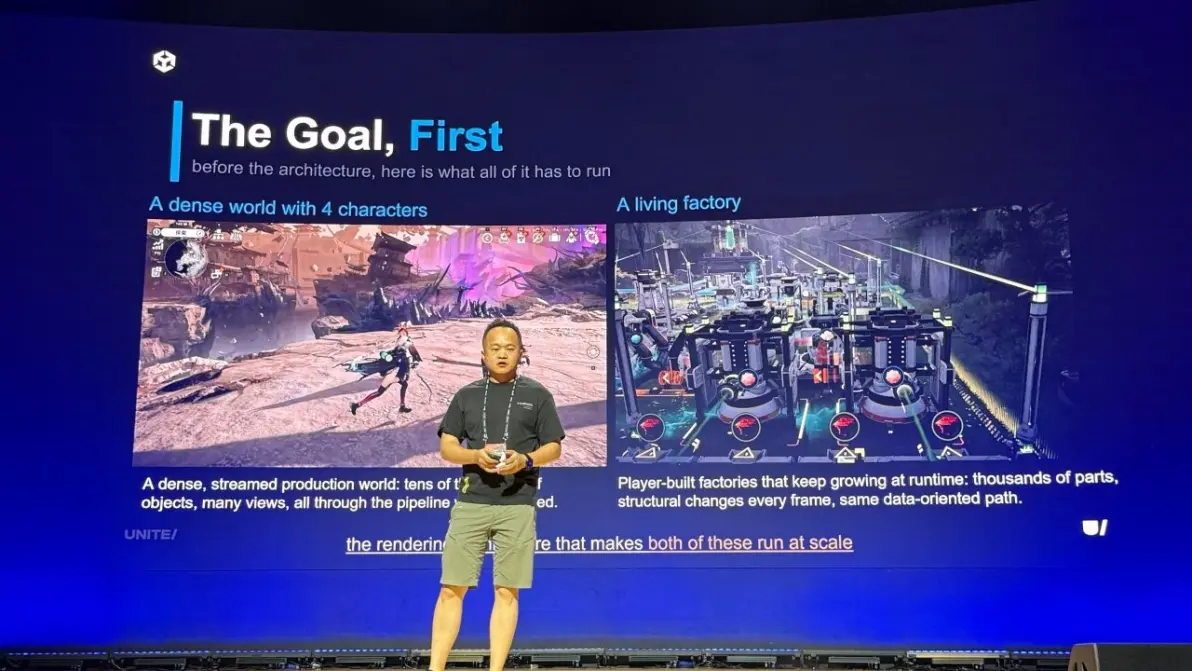
既要支撑高密度世界,又要运行工厂系统,面临着接连不断的技术挑战。[图:“目标优先”]
Honghui Fei 将《明日方舟:终末地》使用的核心渲染技术归纳为四大支柱:
(1)自研 ECS 架构(entity-component system,实体组件系统)
(2)优化剔除(culling)、排序(sorting)、批处理(batching)
(3)C++ 渲染管线与渲染图(render graph)
(4)底层设备抽象(low-level device abstraction)
团队采用自研的 ECS 数据架构,以便在每一帧中快速处理数以万计的可渲染实体。在《明日方舟:终末地》的开放场景和工厂中,大量对象会持续生成和销毁。如果没有能够逐帧高效处理这些对象的数据布局,这部分工作负载很容易成为性能瓶颈。
尽管 Unity 项目通常会采用 ECS 架构处理大量对象,但《明日方舟:终末地》团队仍针对自身负载调整了通用型 ECS。通用系统通常会保留运行时检查和异常处理路径,以维持灵活性;该团队则将这些决策固定在编译期。通过注册运行时类型,移除运行时反射机制(runtime reflection)和哈希表查询,并使用 128 位掩码,使偏移量算术运算只需三个时钟周期即可完成。
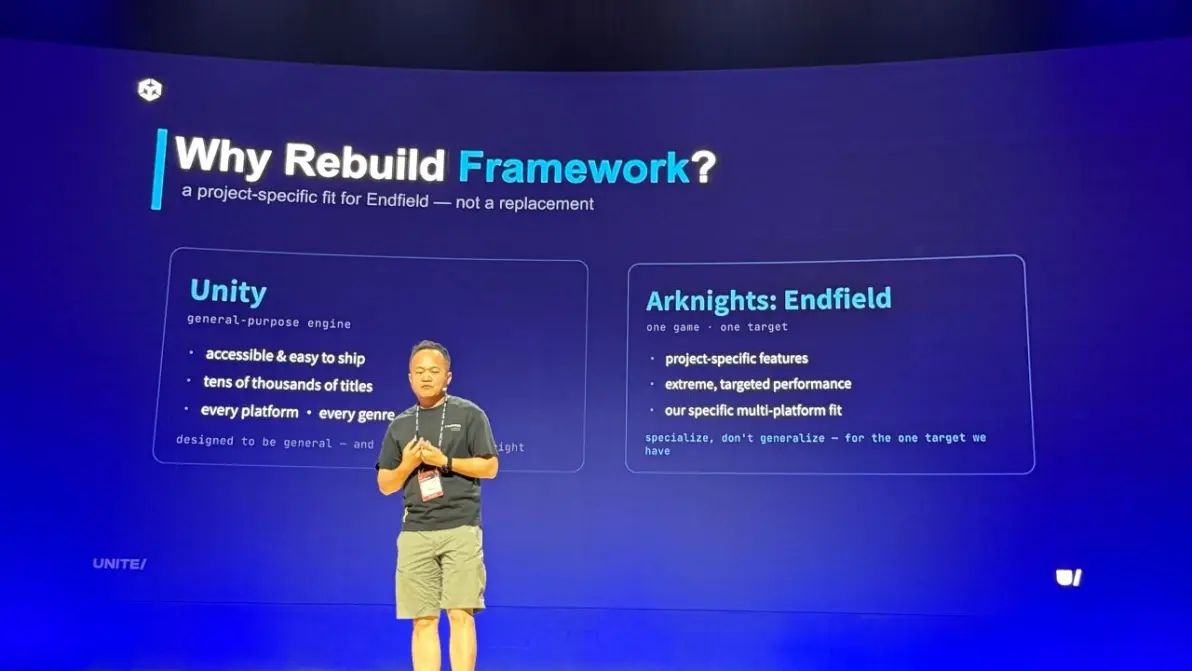
[图:“为什么要重构框架?”]
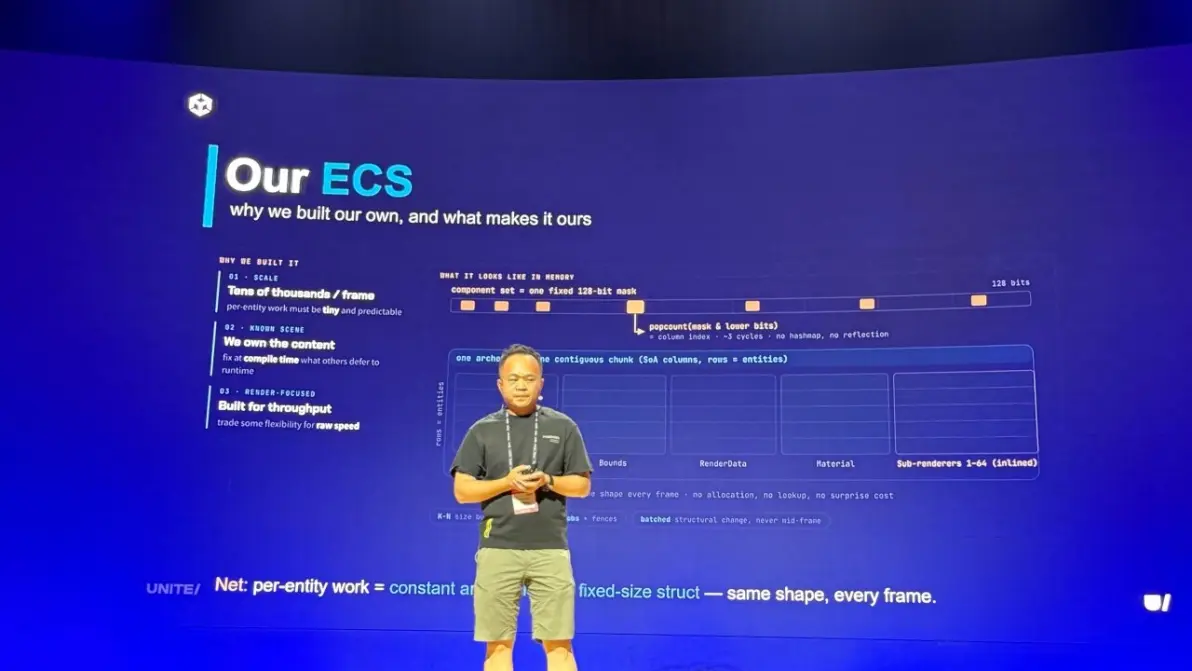
[图:“没有直接照搬现成的 ECS,而是进行了大幅定制。”]
场景处理是另一项挑战。由于《明日方舟:终末地》同时采用 NPR 与 PBR,一帧中可能包含 10~20 个甚至更多视图,用于阴影、反射、光线追踪、流式加载等功能。若按传统方法为每个视图分别生成可见性列表,内存分配与数据复制的开销会显著增加。
因此,团队设计了一套统一剔除系统:不再为每个视图独立执行视锥体测试(frustum test),而是同时处理多个视图并共享结果。团队还引入了软件遮挡剔除(software occlusion culling)。系统先在 GPU 上生成低分辨率深度缓冲,随后由 CPU 使用 SIMD(single instruction multiple data,单指令多数据)运算,通过变换与裁剪、tile binning(图块分箱)以及并行光栅化来快速执行遮挡测试。这样既减少了不必要的可见性计算,又通过为不同图块分配独立线程消除了死锁和原子操作。
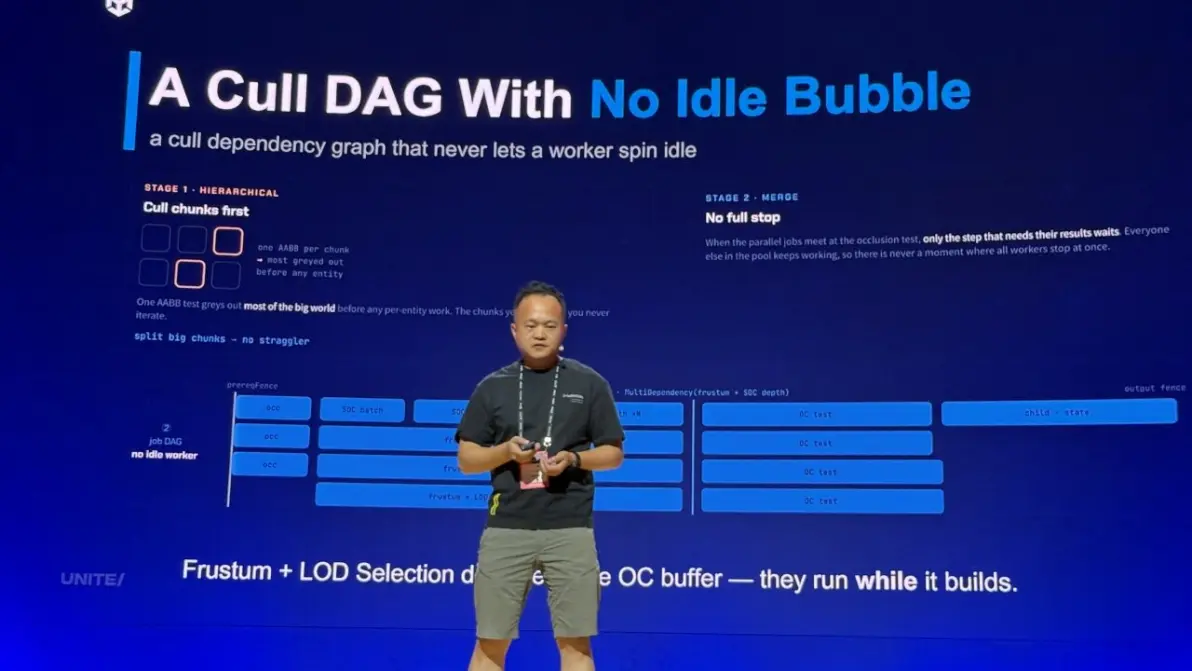
[图:无空闲泡的剔除 DAG(directed acyclic graph,有向无环图)]
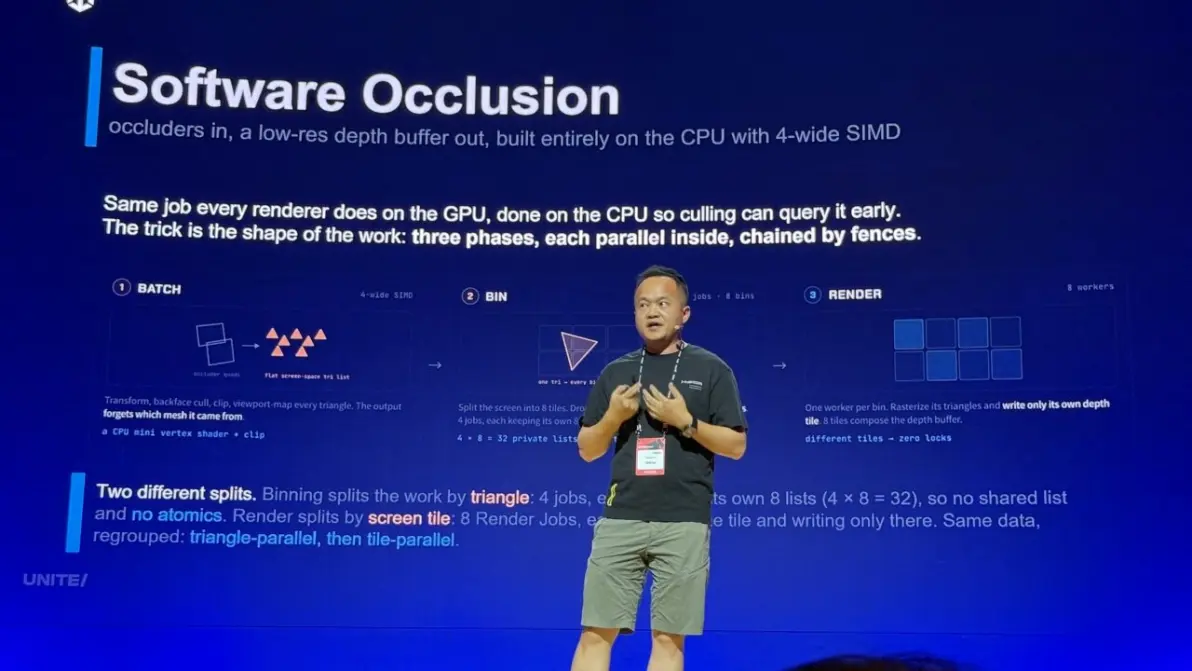
不仅统一了不同视图的剔除流程,还消除了不必要的场景处理工作。[图:“软件遮挡剔除”]
此外,团队将原先 16 字节的排序键结构改为 64 位排序键,使管线状态与网格批处理能够通过一次标准排序完成。团队还让 Vulkan Descriptor Set 2(描述符集 2)引用一个大型缓冲区,仅改变其 dynamic offset(动态偏移量),从而将每帧内存分配降至零,并稳定帧性能。
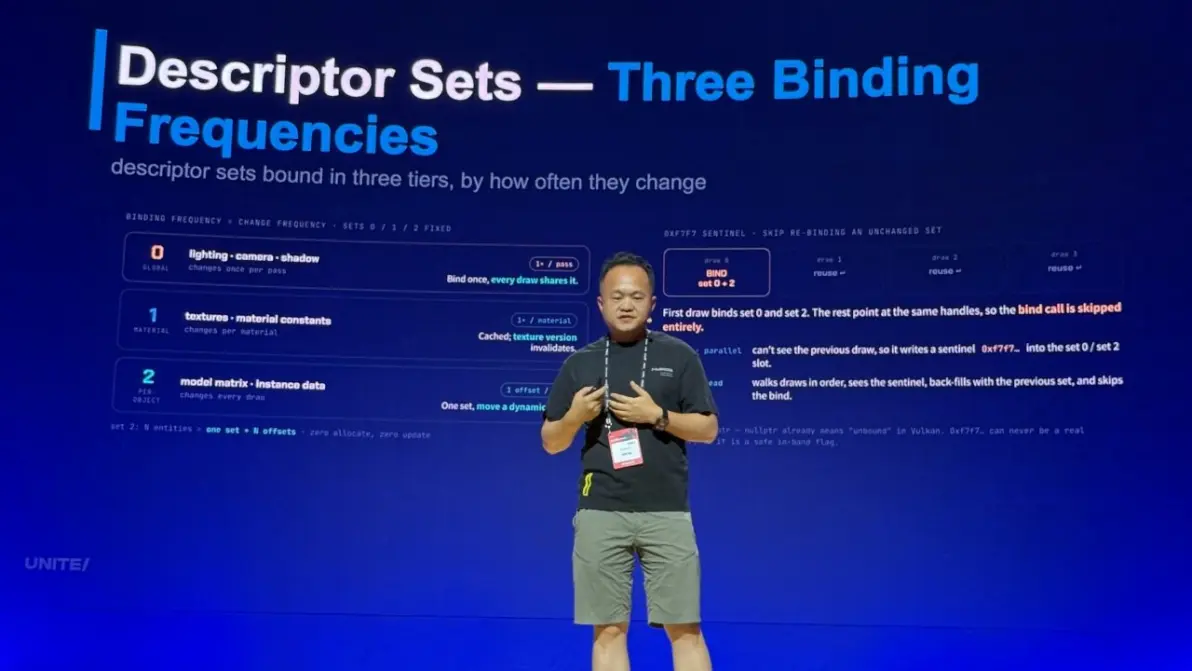
[图:“描述符集的资源绑定,分成三种频率层级”]
采用原生 C++ 渲染管线与受 Vulkan 启发的架构
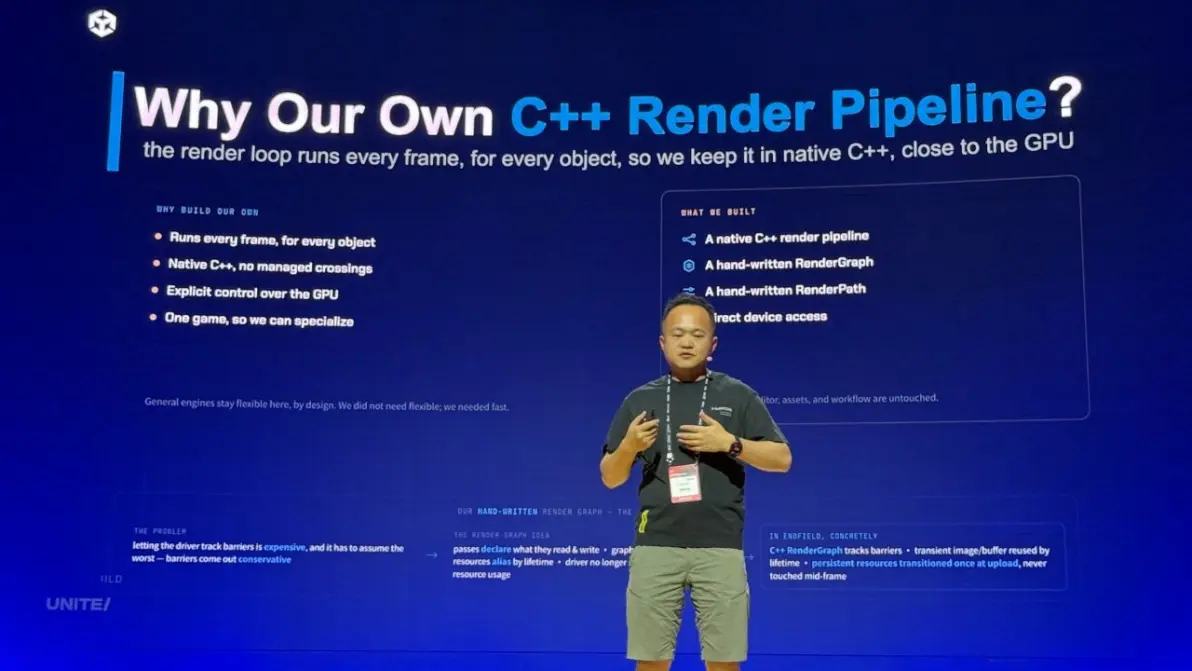
[图:“为什么要自研 C++ 渲染管线?”]
Honghui Fei 随后解释称,团队没有使用 Unity 的标准渲染管线,而是采用原生 C++ 渲染管线。核心渲染路径每帧会被调用数千次,跨语言绑定会在这一路径上产生额外开销,因此团队直接用 C++ 实现了渲染管线。
在前端声明阶段,每个渲染通道(render pass)都使用类型标签(type tag)明确声明其读写资源,使渲染图能够预先确定资源依赖关系。随后,渲染图可以在图刷新点(graph flush point)调度,合并屏障(barrier)调用,避免驱动程序设置过度保守的屏障。对于生命周期互不重叠的临时资源(transient resource),系统还可以通过内存别名复用(memory aliasing)让它们共享同一块内存,从而无需手动管理分配即可降低 VRAM 的峰值占用。
(译注:VRAM通常称“显存”,但在移动端尤其是ARM架构设备 不一定独立于主工作内存,可能共用一块LPDDR,在有独显的PC端也有可能让一部分显存暂时分担在主内存,原文对此没有详细解释,具体情况还得讨论,到底是用主内存分担了专属显存压力,还是包括共享部分的总显存都降低了)
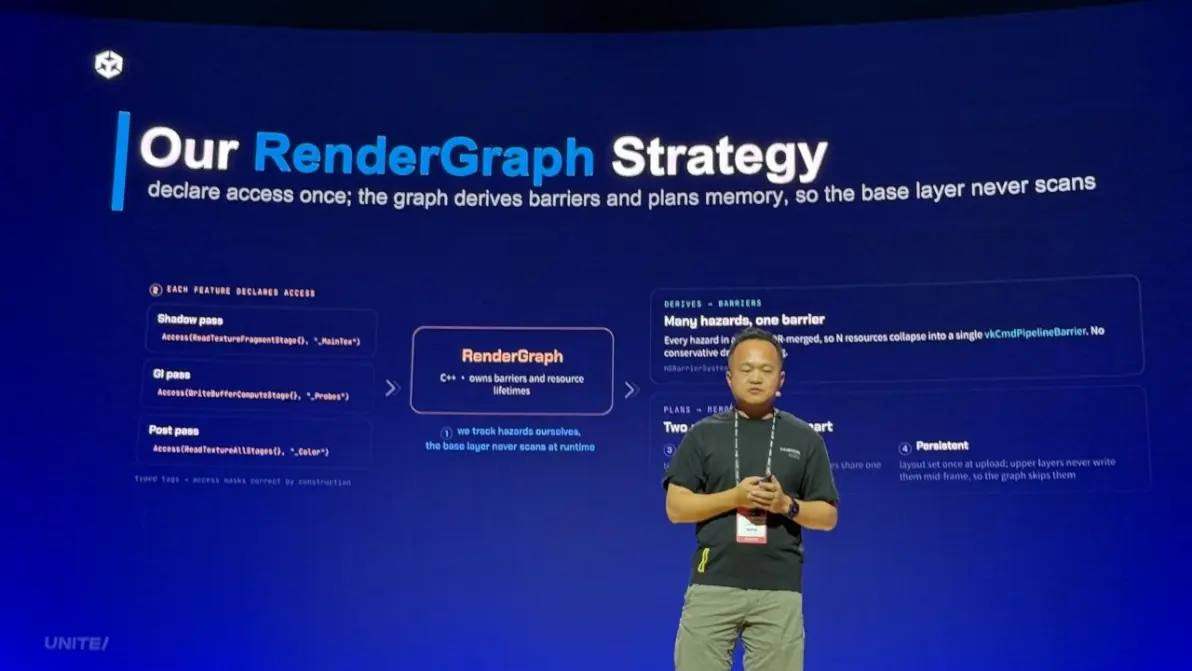
[图:“我们的渲染图策略”]
基于类型标签的资源声明减少了屏障调用和 VRAM 峰值占用。
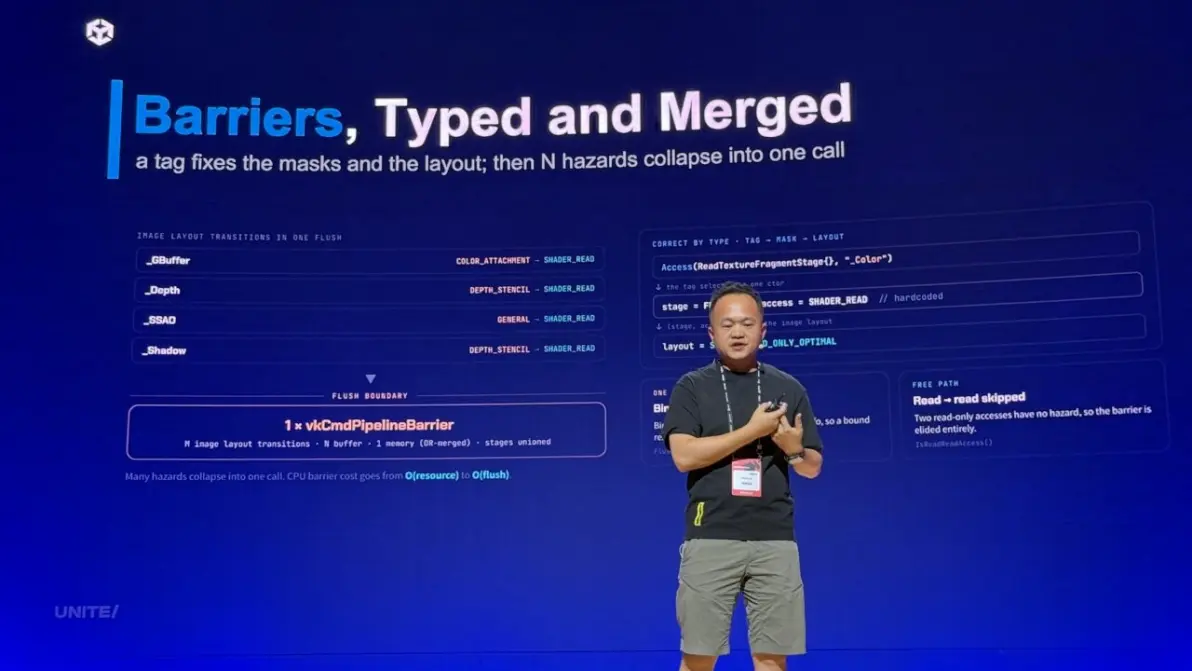
[图:“类型化并合并的屏障”]
最后,Honghui Fei 表示,构建受 Vulkan 启发的设备抽象层至关重要。Vulkan 不会将具体工作隐藏在“draw mesh(绘制网格)”之类的高层 API(application programming interface,应用程序编程接口)之后,而是将 descriptor set(描述符集)、render pass(渲染通道)和 barrier(屏障)等显式概念直接交由开发者控制。这会增加实现复杂度,但也为优化提供了更大的自由度。
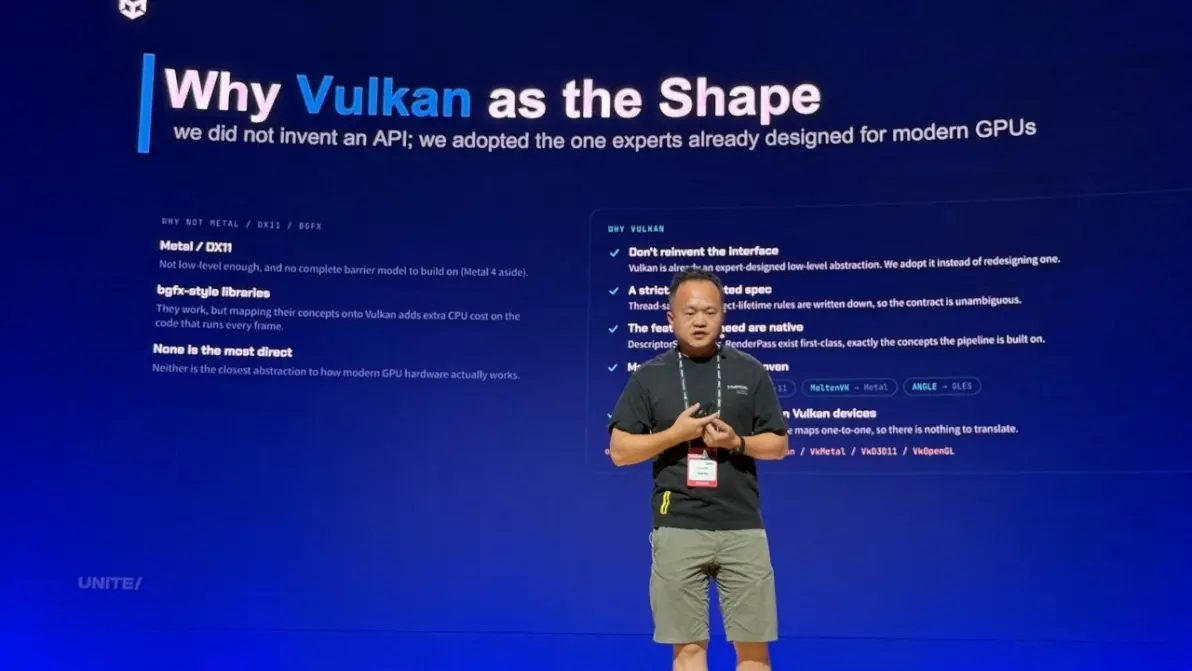
[图:“为什么以 Vulkan 为模型?”]
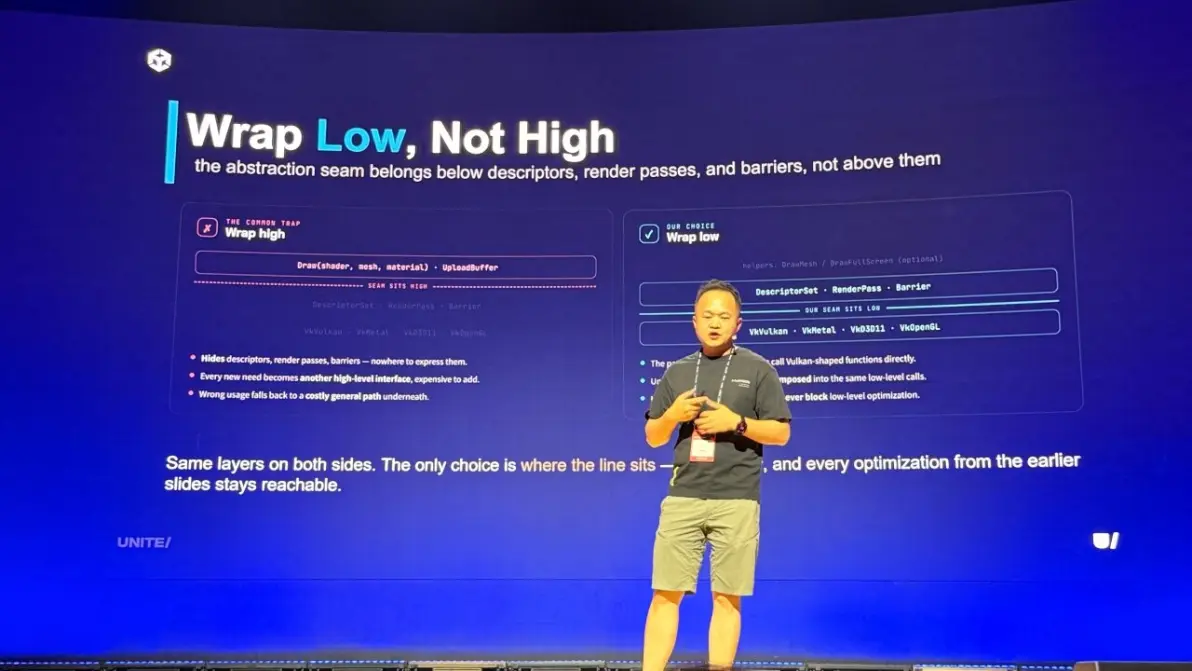
[图:“封装底层,而非高层”]
Vulkan 式底层设备抽象要开发者承担更多工作,但也保留了充分的优化自由度。沿用这一思路,Honghui Fei 与《明日方舟:终末地》团队将各平台图形 API 与引擎之间的边界维持在较低层级。
render pass 和 barrier 仍直接暴露,并由开发者显式指定。团队之所以采用这种设计,是因为增加高层抽象层也需要增加更多高层 API;当引擎遇到未预期的场景结构时,这些 API 可能迫使系统进入 fallback path(回退路径)。结合 C++ 管线后,优化过的数据结构可以直接传递至 GPU 后端,实现零抽象开销。
采用这套设计后,在搭载 Snapdragon 8 Gen 1 的移动设备上,剔除流程可将 500,000 个候选对象缩减至实际渲染所需的数万个;在 PC 上,则可将 600,000 个候选对象缩减至约 60,000 个。如此高的剔除率使每帧处理负载保持在较低水平:Android 端的批处理仅耗时 3 ms,PC 端仅耗时 1 ms。
Honghui Fei 在总结中表示:“在 Unity 所提供的高生产力基础上,结合自研 ECS、统一的剔除与排序 pass(处理阶段)、C++ 渲染管线以及底层设备抽象,我们得以在稳定帧率下渲染大规模对象。”他还指出,未来仍需研究更为多样化的分析与处理体系,以突破传统对象结构的限制。
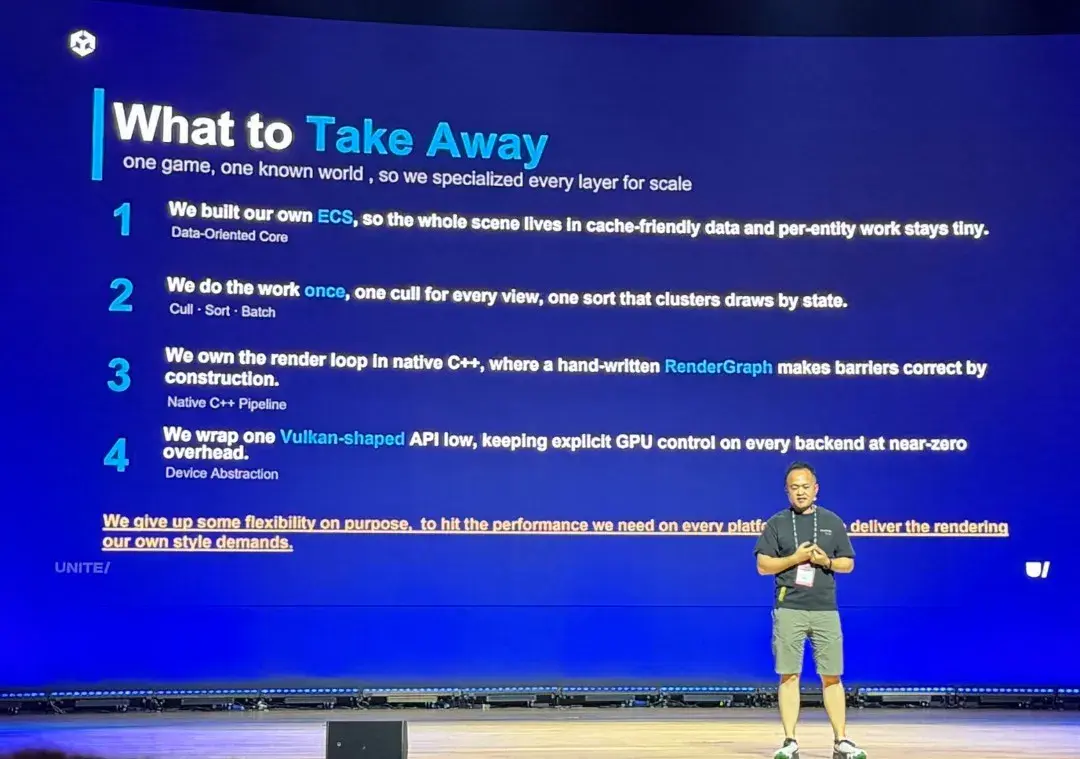
这四项原则构成了整体渲染设计的基础。[图:“何以取舍”]
总结:同一个游戏,同一个已知的世界,因此我们为了扩展性而对每一层都进行了针对性优化。
1.构建了自己的 ECS,因此整个场景都保存在对缓存友好的数据结构中,且每个实体的工作量保持极小。( 数据导向型核心)
2.只做一次工作,对每个视图仅一次剔除,一次按状态聚合绘制的排序。(剔除 · 排序 · 批处理)
3.在原生 C++ 中掌控渲染循环,其中手写的 RenderGraph 确保了屏障从结构设计上就是正确的。 (原生 C++ 管线)
4.在底层封装了一个类 Vulkan 的 API,在所有后端上以近乎零的开销保持对 GPU 的显式控制。( 设备抽象)
我们有意放弃了一部分灵活性,以达到在每个平台上所需的性能,并交出我们自身风格所要求的渲染效果。
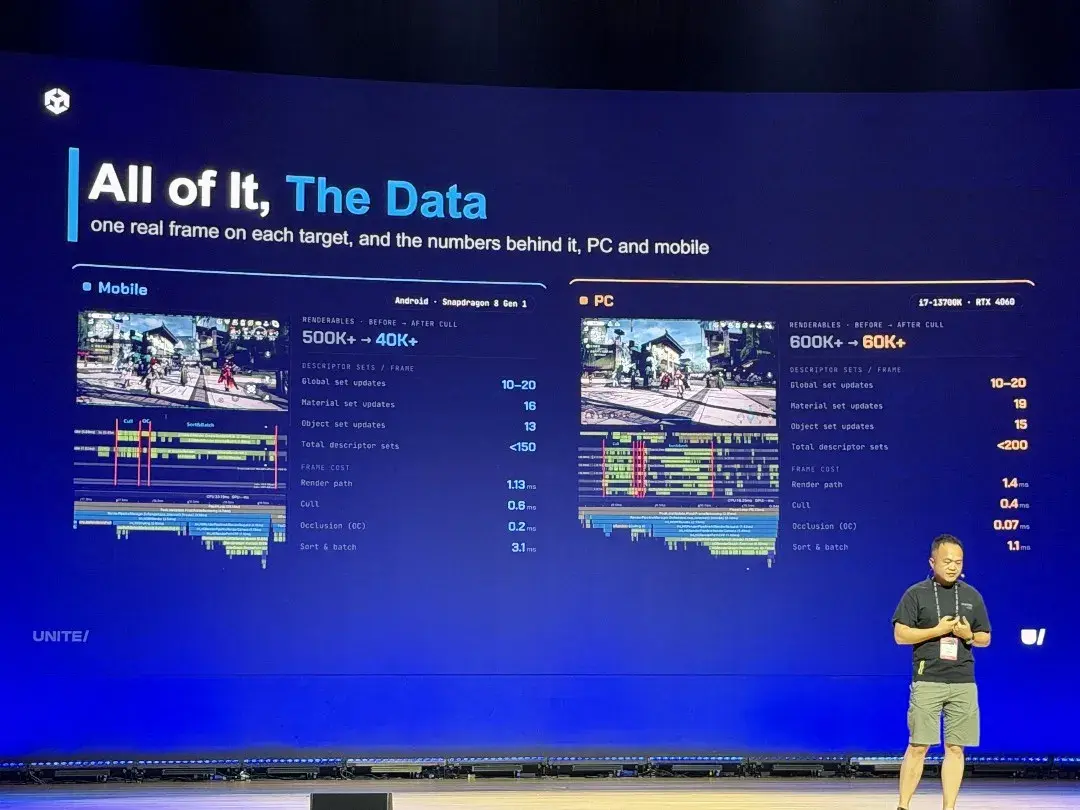
正是这些技术共同造就了《明日方舟:终末地》当前的画面质量与性能表现。
韩语报道原文: https://www.inven.co.kr/webzine/news/?news=318725
因为我没学过韩语,整篇文章用了朋友做的学术翻译工具 geyi.net 翻译成中文后,我再自己核查了一遍技术用语的准确性,有问题欢迎指出。原报道媒体自己也发布了一篇机翻的英文版报道,但里面有不少技术用词错误翻译,本文没有采用。
演讲本身被标记为“参会者专属”,并没有任何公开的录播和直播,演讲所用的PPT也暂时没有找到更完整的图。
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文





 155-2731-8020




