




软件

产品


在心理健康服务日益精细化的今天,多量表联合评估已成为心理状态研判的核心手段,但量表数据的多样性、量化指标的差异性的问题,导致传统评价方法易出现主观性强、分类模糊的痛点。作为数据分析师,我们在过往客户咨询项目中发现,单一方法难以兼顾分类准确性与评价客观性,因此探索出多算法融合的解决方案——通过聚类、降维、统计检验与客观赋权方法结合,构建适配多心理量表的数据处理体系。 本文围绕SL-90症状自评量表、职业成熟度量表、大五人格量表三类数据,搭建从数据预处理到评价验证的全流程模型,依次实现量表分类、综合聚类、分组差异研判与评价方法校验。模型核心创新在于将熵权TOPSIS法与K-means聚类结合,通过客观赋权规避人为权重偏差,同时用K折交叉验证保障结果可靠性。 本文内容改编自过往客户咨询项目的技术沉淀并且已通过实际业务校验,该项目完整代码与数据已分享至交流社群。阅读原文进群,可与800+行业人士交流成长;还提供人工答疑,拆解核心原理、代码逻辑与业务适配思路,帮大家既懂 怎么做,也懂 为什么这么做;遇代码运行问题,更能享24小时调试支持。
项目文件目录
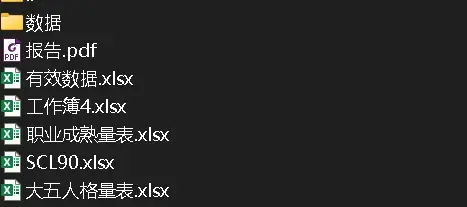
数据基础
本次采用三类核心心理量表数据,分别从心理症状(SL-90症状自评量表)、职业适配度(职业成熟度量表)、人格特质(大五人格量表)三个维度采集信息,覆盖168名评估对象,为后续分析提供全面数据支撑。
预处理流程
首先对原始数据进行清洗:剔除极端异常值,针对空白值采用众数填补法补全,确保数据完整性。此步骤可规避残缺数据对后续模型的干扰,为分析结果可靠性奠定基础。
核心方法简化说明
分类实现
采用频数分析对三类量表分别完成分类,计算各得分区间的频数及占比,形成分类标准:评估对象得分落入对应区间,即可判定其所属类别。
分类结果验证
对三类量表的频数分布进行可视化分析,结果如下:
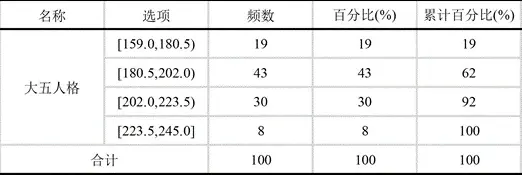
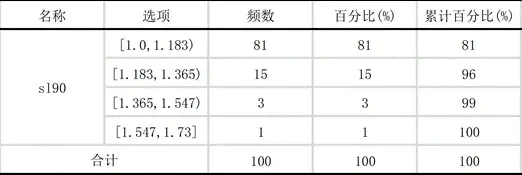
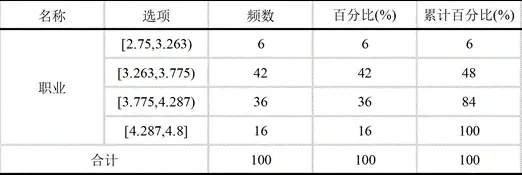
图1 三类量表频数统计图
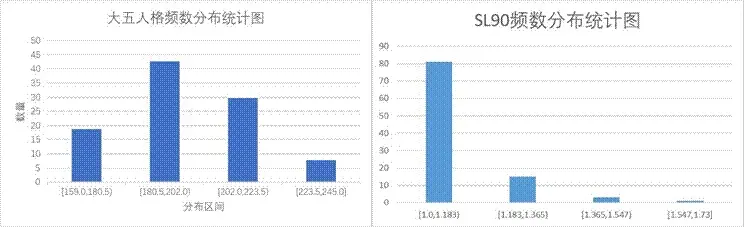
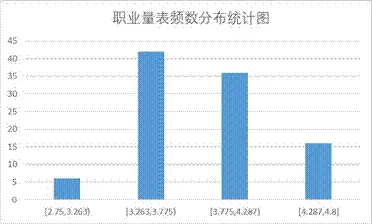
图2 频数分布条形统计图 从分布特征来看,职业成熟度量表与大五人格量表的频数分布接近正态分布,符合心理评估数据的普遍规律,证明分类标准具有科学性;SL-90量表某一区间占比达90%,因该量表用于心理健康筛查,健康人群占比偏高的结果贴合实际应用场景。
分类结果关联性检验
采用Kendall’s W检验验证三类量表分类结果的一致性,检验结果如下表所示:
名称秩平均值中位数Kendall’s W系数X²PSL-9011.0712000.000***大五人格3194.5---职业成熟度23.78---
注:***代表1%的显著性水平 检验结果显示Kendall’s W系数为1,表明三类量表的分类结果几乎完全相关,说明不同维度的心理评估具有一致性,为后续综合分析提供了合理性支撑。
相关文章
原文链接:https://tecdat.cn/?p=37724
降维处理
先通过KMO检验与Bartlett检验验证数据适配性,检验结果显示KMO值为0.525,Bartlett球形度检验P值小于0.001,表明数据适合进行主成分分析。 采用PCA主成分分析对三类量表数据降维,提取特征根大于1的主成分,结果显示前两个主成分的累积方差解释率达86.917%,可充分保留原始信息。降维后各量表在主成分上的载荷系数如下:
量表主成分1主成分2共同度SL-90-0.5910.7850.966大五人格0.7840.490.855职业成熟度0.8820.0910.787
聚类实现
基于降维后的数据进行K-means聚类,通过对比不同簇数的距离平方和确定最优簇数为5,此时距离平方和降至2158.375,聚类效果较优。
聚类核心代码(MATLAB改写)
代码块
cobol
复制成功
一键获取完整项目代码
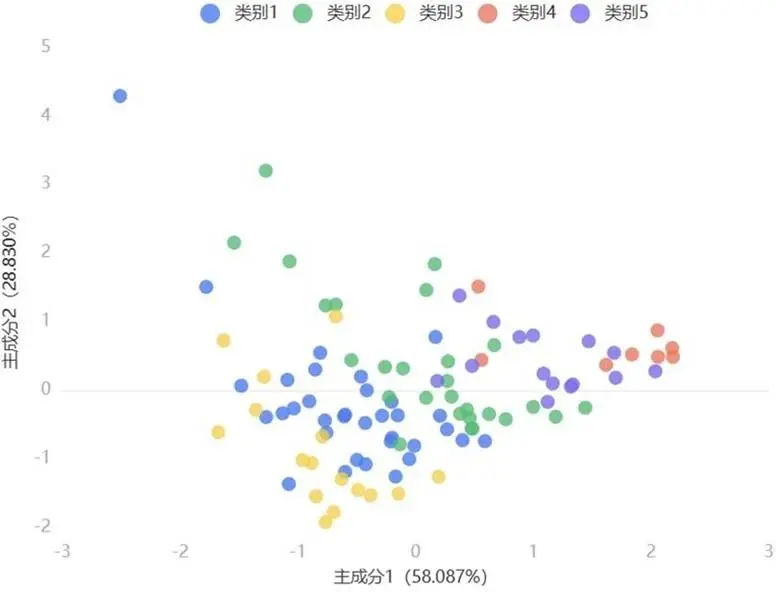
代码功能:导入降维数据后,以5为簇数执行K-means聚类,通过散点图可视化聚类结果,标注各簇中心位置,直观呈现分类效果。
聚类结果分析
聚类结果如下表所示,5个簇的占比分别为34%、27%、16%、8%、15%,分布相对合理。
聚类类别频数百分比%13434227273161648851515合计100100
各聚类中心对应的原始量表得分如下:
聚类种类SL-90大五人格职业成熟度量表11.115187.5593.55321.132201.4813.86531.103168.6253.70841.030231.1254.32551.062216.5334.252
可视化结果显示,各簇整体区分度良好,但簇1与簇2、簇2与簇5存在少量重叠,后续可通过算法优化提升分离度。
分组差异分析
采用T检验对比两组评估对象的量表数据,研判组间差异:SL-90量表两组数据的P值小于0.001,Cohen’s d为1.309,表明组间差异显著;大五人格量表P值为0.918,职业成熟度量表P值为0.001但Cohen’s d仅0.355,两组量表的组间差异不明显。 结果提示,两组评估对象的心理症状表现差异较大,而人格特质与职业适配度的差异较小,可为针对性心理服务提供方向。
评价方法准确性验证
采用熵权TOPSIS法构建综合评价模型,客观计算各量表权重,再通过K折交叉验证检验模型可靠性。
熵权计算结果
量表信息熵值e信息效用值d权重(%)大五人格0.970.0355.374职业成熟度0.9810.01934.307SL-900.9940.00610.319
结果显示,大五人格量表权重最高,对综合评价的影响最大,符合人格特质在心理评估中的核心地位。
K折交叉验证核心代码(MATLAB改写)
代码块
cobol
复制成功
一键获取完整项目代码
代码功能:按9:1比例划分数据,通过支持向量机训练模型,计算准确率、召回率、精确度三个指标,验证评价模型可靠性,最终结果显示准确率0.9492、召回率0.9128、精确度0.9389,模型表现优异。
聚类优化结果
基于熵权TOPSIS法的综合得分再次进行聚类,仍划分为5个簇,聚类结果的F值为556.892,P值小于0.001,表明各簇间差异显著。
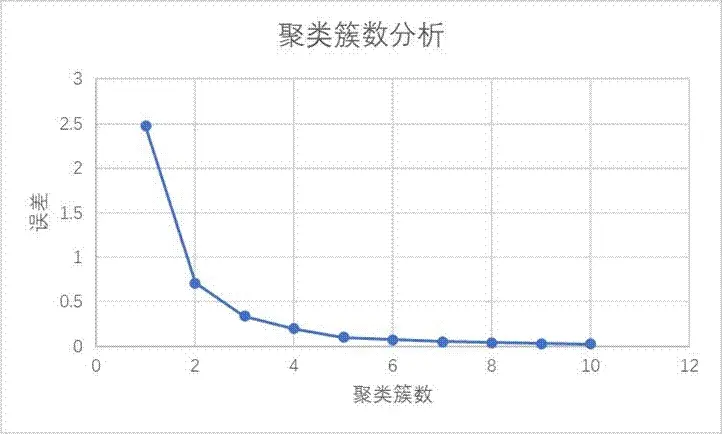
图3 熵权法评价聚类分析图
模型优势与应用价值
优势在于多算法融合,通过客观赋权与交叉验证规避主观性,结果可靠性高;覆盖分类、聚类、差异分析、评价验证全流程,适配心理评估实际需求。可广泛应用于心理服务机构的评估筛查、人才选拔的心理适配度研判等场景。
优化方向
工具适配说明
1. PCA主成分分析代码(MATLAB改写)
代码块
cobol
复制成功
一键获取完整项目代码
2. 熵权TOPSIS法核心代码(MATLAB改写)
代码块
复制成功
一键获取完整项目代码
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文





 155-2731-8020




