

软件

产品


导读:Ansys(现属Synopsys)发布了Electronics Desktop 2026 R1,这不是一次常规版本更新——HFSS-PI首次实现全芯片-封装-板级宽带电源完整性3D仿真,cuDSS分布式GPU并行让射频扫频速度提升3~10倍,Maxwell 2D瞬态求解器引入一阶元技术提速40%+,Icepak原生CPU/GPU焦耳热求解让散热仿真进入异构加速时代,而GeomAI和SimAI的嵌入标志着电子EDA正式迈入"AI赋能"阶段。但在这"一键生成符合工程约束的新结构、GPU秒级完成原本数小时的频域扫描"的优雅背后,藏着电子仿真的算力真相:HFSS-PI的宽带PDN仿真涉及超大规模稀疏矩阵、毫米波天线阵列的Omega网格器生成数百万网格单元、Maxwell瞬态求解的时间步长与电机转速耦合导致数十万步积分、而2.5D/3D Chiplet的多物理场可靠性分析需同时调度电磁-热-结构三场求解器。当你的设计对象从单颗PA芯片扩展到AI服务器整板、从单层PCB扩展到CoWoS先进封装、从单一物理场扩展到Synopsys-Ansys跨工具数据流时,你的工作站的GPU显存和系统内存,还能跟上这场"GHz频率×μm精度×多物理场×AI生成"的四维算力风暴吗?
图片
AI算力爆发推动PCB信号速率和电流密度双双攀升:
信号完整性(SI):PCIe Gen5/6、USB4、DDR5/6、112G PAM4 SerDes,眼图裕量压缩至ps级
电源完整性(PI):AI芯片功耗数百瓦,PDN阻抗需在宽频带(DC至GHz)内低于目标值
热协同:高功耗芯片与密集走线导致局部热点,需电磁-热联合评估
2026 R1升级:HFSS-PI宽带电源完整性求解器首次实现全芯片-封装-板PDN的宽带3D仿真;SIwave与HFSS-PI深度集成,板级PDN与信号完整性联合仿真更流畅。
5G/6G Massive MIMO:64/128单元阵列,28GHz/39GHz毫米波频段,波束赋形精度要求极高
车载雷达:77GHz/79GHz FMCW雷达,天线-馈电-封装联合优化
可穿戴/IoT:小型化、多频段、人体耦合效应
2026 R1升级:GPU加速频域扫描(cuDSS),分布式GPU并行让射频分析速度提升3~10倍;Omega网格器针对刚挠结合PCB提升复杂弯折结构网格成功率并降低内存占用。
Chiplet和HBM堆叠带来前所未有的多物理场挑战:
电磁串扰:硅中介层(Silicon Interposer)密集RDL走线间的耦合
电源 delivery:TSV阵列与微凸块的电流密度和压降
热-机械应力:CTE不匹配导致的翘曲、焊点疲劳、分层
2026 R1升级:Q3D寄生参数提取速度与容量提升,适配先进封装与高密度PCB;Sherlock嵌入Mechanical实现应力-寿命闭环,热雨流计数与BGA寿命预测更精准。
电机/变压器:Maxwell 2D/3D低频电磁,铁损、铜损、效率Map计算
功率模组:SiC/GaN开关瞬态,母排杂散电感提取
无线充电:线圈耦合、涡流损耗、异物检测
2026 R1升级:Maxwell 2D瞬态求解器一阶元技术速度提升40%+;AC磁A-Phi格式让频域损耗、电压、电磁力分析更高效;3D组件全加密保护IP同时保留仿真精度。
系统级散热:服务器机柜、EV电池包/电控/电驱热管理
焦耳热精确计算:PCB铜皮电流分布→局部发热→温度场→反馈电导率
寿命预测:温度循环、功率循环下的焊点/封装疲劳
2026 R1升级:Icepak原生CPU/GPU焦耳热求解,稳定性大幅提升;STM(系统热模型)流程设置提速3~5倍,点击量减少80%。
HFSS基于频域有限元求解3D Maxwell方程:
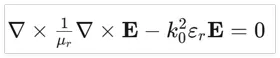
图片
HFSS-PI(Power Integrity)算法:
传统PI仿真将PDN简化为集总RLC或2D提取,HFSS-PI实现全3D宽带电磁提取
从DC到GHz的连续频域求解,捕捉平面谐振、腔体谐振、去耦电容反谐振
超大规模稀疏矩阵,迭代求解器(如ICCG)或稀疏直接求解器
计算特点:
网格规模:毫米波天线/封装细节导致数百万至数千万四面体单元
频域扫描:宽带S参数需数十至数百频点,各频点矩阵需重新组装/预处理
GPU加速(cuDSS):将稀疏直接求解器的因子化 offload 到GPU,显存是硬门槛
内存占用:3D FEM自由度随网格线性增长,但稀疏矩阵填充率受几何复杂度影响
瞬态求解器(2D/3D):
时域积分Maxwell-Ampère方程,处理旋转电机、开关瞬态
一阶元技术(2026 R1新增)降低自由度数量,提升40%+速度
A-Phi格式(AC磁):
磁矢势A + 电标势Φ耦合求解,适用于频域涡流、损耗、电磁力
相比传统A-only格式,数值稳定性更好,收敛更快
计算特点:
瞬态求解时间步长受模型最小尺寸和转速限制,电机高速旋转仿真步数可达数十万
非线性铁磁材料(B-H曲线)每步需Newton-Raphson迭代,CPU主频敏感
3D涡流求解网格需穿透趋肤深度,内存密集型
Icepak基于CFD求解Navier-Stokes与能量方程:
焦耳热求解:从Maxwell/Q3D提取铜损分布,作为体热源输入Icepak
原生GPU加速:2026 R1支持GPU加速焦耳热计算,利用CUDA核心并行处理大规模网格
计算特点:
系统级热模型网格数可达数百万至千万,内存容量敏感
焦耳热与电-热耦合需迭代求解,多核CPU+GPU协同
瞬态热分析(如功率循环)时间跨度大,步长自适应切换
SIwave:2.5D全波提取PCB电源/信号网络,基于边界元法或有限元法
Q3D:准静态3D寄生参数提取(R/L/C/G),基于有限元或边界元
计算特点:
SIwave/Q3D的矩阵规模随PCB层数和过孔密度快速增长
先进封装(2.5D/3D)的硅中介层提取,内存占用可达数十GB
多端口S参数/Y参数提取可部分并行
GeomAI:生成式几何,基于参考几何+工程约束自动生成新结构
SimAI:基于仿真数据训练代理模型,实现无代码快速预测
计算特点:
GeomAI的生成过程需调用几何内核和约束求解器,CPU主频+内存
SimAI训练阶段需GPU加速(CNN/ResNet级网络),推理阶段轻量
表格
核心矛盾:Ansys Electronics 2026 R1是"GPU显存+内存+CPU主频"三维敏感场景——HFSS cuDSS吃GPU显存,大型3D EM和热仿真吃内存,Maxwell瞬态和AI生成吃主频。
Ansys Electronics Desktop 2026 R1:统一界面,集成HFSS/Maxwell/Icepak/SIwave/Q3D/Sherlock
HFSS:3D全波高频电磁,天线、射频、高速互连、EMC
HFSS-PI:宽带电源完整性,芯片-封装-板联合PDN
Maxwell 2D/3D:低频电磁,电机、变压器、磁性元件、涡流
Icepak:电子散热,系统级热管理,焦耳热
SIwave:PCB信号/电源完整性,谐振分析,去耦优化
Q3D Extractor:寄生参数提取,RLCG矩阵
Sherlock:电子可靠性,焊点疲劳,寿命预测
GeomAI:生成式几何设计,概念设计加速
SimAI Pro/Premium:本地组件级实验+云端预测建模
Python + PyAnsys:Ansys自动化脚本,批量参数扫描
MATLAB:自定义算法、优化、与Ansys联合仿真
Synopsys-Ansys联合流程:Sentaurus(芯片)→Ansys(封装/系统)无缝数据流
Ansys Workbench:多物理场协同平台,HFSS→Icepak→Mechanical数据传递
Ansys Minerva:仿真流程与数据管理(SPDM)
基于Ansys Electronics 2026 R1的负载特征——HFSS GPU显存密集、3D EM/热内存密集、Maxwell瞬态主频敏感——推荐以下三档方案:
相关机型 UltraLAB GT450P
表格
适用场景:射频/高速工程师个人工作站,5G天线设计、中小规模PCB SI/PI验证、电机2D瞬态分析、热仿真初步评估。
相关机型 UltraLAB GR450P
表格
适用场景:通信/半导体企业研发部,承担5G毫米波模组、2.5D/3D Chiplet封装、AI服务器PCB、EV电机控制器,需多物理场(EM-热-结构)协同与参数化优化。
机型 UltraLAB GA660M
表格
适用场景:国家级电子实验室、大型芯片/模组企业研发中心、5G/6G预研团队,支撑整机级EMC辐射仿真、Synopsys-Ansys芯片-封装-系统全流程、多用户协同设计。
HFSS 2026 R1的cuDSS分布式GPU加速,将稀疏直接求解器的因子化 offload 到GPU。一个中等规模的毫米波天线阵列(64单元,28GHz)3D FEM模型,GPU显存需求可达20~40GB;整机级EMC或大型封装模型需60GB+。32GB是中小规模入门底线,72GB是主力标配,96GB才能驾驭大型3D EM GPU加速。
HFSS-PI的宽带PDN仿真、Maxwell 3D涡流、Icepak系统级热,都需要在内存中存储大规模稀疏矩阵或CFD网格。先进封装(Chiplet+HBM)的HFSS-PI提取,内存占用轻松超过150GB。128GB是中小规模入门底线,256GB是主力标配,512GB才能驾驭整机级多物理场全耦合。
Maxwell 2D/3D瞬态求解器处理电机旋转或开关瞬态时,时间步长受模型最小尺寸和转速限制,总步数可达数十万。非线性铁磁材料的Newton-Raphson迭代每步都需重新组装Jacobian。主频从3.5GHz提升到4.8GHz,单次仿真时间缩短25~35%。液冷超频是电机/功率电子仿真性价比最高的投资。
HFSS宽带S参数扫描通常需数十至数百频点,各频点独立可并行;Q3D的多工况提取也可并行。96核/112核平台可同时处理12~20个频点/工况,将原本数小时的宽带提取压缩到数十分钟。这是高核心数CPU在电子EM仿真中的核心价值。
电子仿真项目文件(aedt/hfss/maxwell)体积巨大,单个项目可达数GB至数十GB。建议采用PCIe 5.0 NVMe作为活跃工作区(加载当前仿真项目),SATA HDD作为历史归档,避免机械硬盘拖慢大型模型加载。
Ansys Electronics 2026 R1的发布揭示了一个清晰趋势:电子仿真正在从"单点工具"走向"芯片-封装-系统全链路协同",从"CPU串行"走向"GPU异构加速",从"手工建模"走向"AI赋能生成"。HFSS-PI的宽带PDN、cuDSS的GPU分布式加速、GeomAI的生成式几何、SimAI的无代码预测——这些能力让工程师能在统一平台上完成从晶体管到系统的全链路验证。但在这"协同化+智能化"背后,电子仿真的算力需求更加聚焦:HFSS吃GPU显存,3D EM和热吃内存,Maxwell瞬态吃主频。
对于高校电磁场教授、芯片封装工程师、射频研发总监而言,选择一台能够支撑Ansys Electronics 2026 R1全功能释放的图形工作站,已不是"配置够用就行"的保守策略,而是缩短电子设计周期、提升先进封装仿真精度、抢占5G/6G/AI芯片技术制高点的核心投资。
UltraLAB面向电子EDA与多物理场仿真场景,提供从液冷超频单卡工作站到四卡旗舰融合平台的完整方案,深度优化Ansys Electronics Desktop、HFSS、Maxwell、Icepak、SIwave及Python/SimAI自动化环境的硬件协同,助力您的团队从"单点仿真"走向"全链路驾驭"。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
咨询微信号:wolf_chen1989
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文


 155-2731-8020