




软件

产品


好的,各位同学大家好。今天我要给大家分享的是我们Unity主程进阶之路系列的其中一个专题,就是关于内存管理与垃圾收集的。
不管是进阶主程,或者优化项目性能,内存管理的知识都是我们必须掌握的。
甚至于如果你是在准备入行,那么内存管理、优化与垃圾收集也是经常会被考到的一个专题。
那么废话不多说,下面我们来看一下本次直播的主要议题吧:
本次直播我会从三个方面给大家讲解内存管理和垃圾收集的知识:
好,下面我们就来看第一个主题:CPU如何访问内存。
首先我们需要知道的一个概念,就是我们现代的计算机,它的内存访问是一种多级的内存结构。
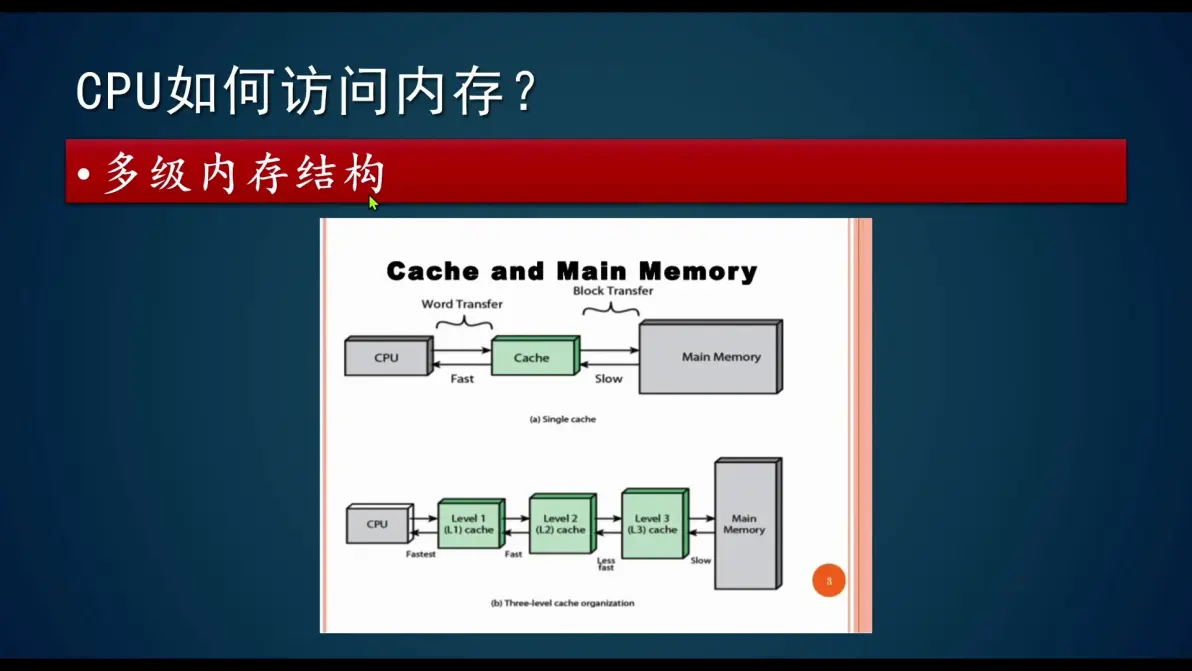
比如说,我们电脑里面有CPU,但CPU不会直接从我们的主内存里面去直接去访问数据。
所以,主内存是什么?
如果你拆开过台式机看过,你就会知道——主内存就是机箱里那根内存条
那么我们的CPU不会直接通过主板去访问内存条里面的这个数据。
你可以想象一下:CPU到我们的主内存去抓数据,它中间经过了一条很长的链路,本身这个链路的访问是需要时间的。
大家可能觉得CPU访问主内存速度很快,但站在CPU的视角,会觉得很慢!
所以,CPU到底怎么访问内存?
首先,它是从我们的CPU里面有一个专门的机构叫做Cache,也就是我们俗称的缓存,CPU先从缓存里面去抓数据。
那这种访问方式是比较快的。
CPU虽然可以直接访问Cache,但是本身Cache的存储容量是比较小的,所以说你不可能把什么数据都放在Cache里,而是要从我们的主内存里面把一些核心的数据抓到我们的Cache里面来进行访问。
那么CPU是如何访问我们的Cache的呢?
首先,它的访问单位是”字“。
一般来讲,在我们的CPU,在我们的现在的电脑结构里面,一个字就是64位。
由此可见,Cache的访问带宽比较小,而且容量也小,但是它胜在频率快。
如果Cache里面实在抓不到数据了,那这个时候我们就会从我们的主内存里面去抓数据。
那这种访问是基于Block,也就是基于块来进行访问的。
一个数据块比一个字访问的这个带宽要大得多,但是它访问的频率会相应的慢不少。
Cache造价比较高,
所以说如果我们建立很多的很大块的缓存,那显然这个CPU的成本就会高不少。
因此为了扩容,在我们的CPU的构造里面,又把缓存再分成三级。
在最早的CPU里面,缓存只有一级。
到了下一个世代以后,缓存增加到两级。
现在很多CPU的缓存增加到三级了。
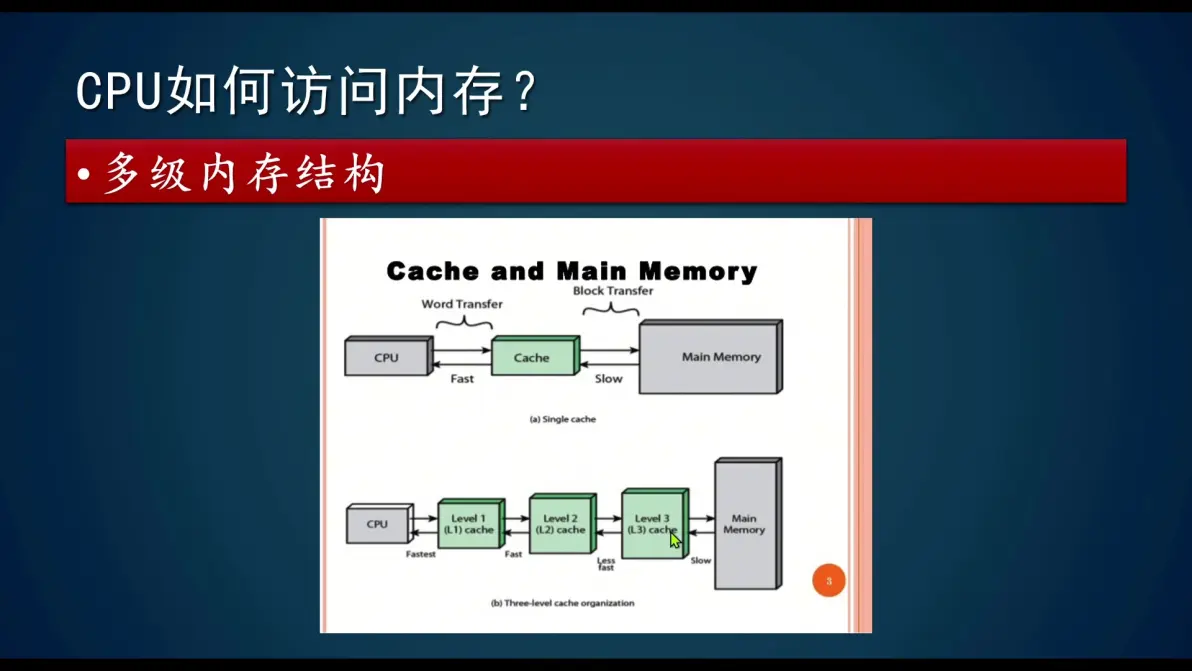
CPU缓存层级示意图
就像我们这个图上面所展示的,那么:
这个是我们现代CPU的结构,就不管你用的是手机的CPU,还是用的是主机PC上面的CPU,它都是这么一个结构,没有太大区别。
很多同学平时在学习的过程中,可能更多的了解的是内存。
但是缓存,在硬件上是一个什么结构呢?
下面给大家重点讲一讲。
假如说我们把一个CPU去做拆解,那么你会发现是CPU里面标记为”Core“的,是它用来进行计算的核。
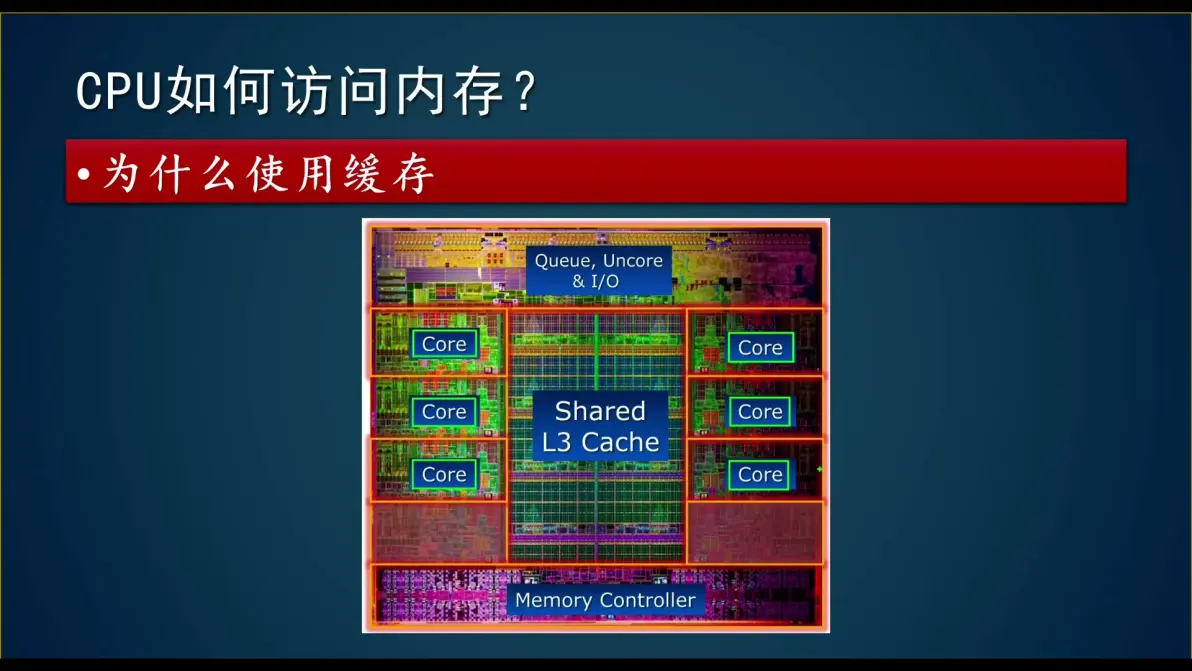
CPU核心与缓存分布图
我用这个绿色去表示,你看一个核,两个核,三个核,这边是第四个核,第五个核,第六个核。
那么这些核的数量其实并不多。
那么CPU里面占最大面积的一块,反而是我们的缓存区域。
大家看中间这一块这个区域上面写的L3 cache,这个是在我们CPU里面占最大面积的一块。
这个说明什么问题呢?
你可以发现,其实在CPU里面,影响计算速度最大的这个因素,并不是我们拥有多少个核,或者每个核的计算速度是多少。
最重要的是——缓存的级数和容量大小。
所以说你可以看到I3,I5,I7,甚至I9,他们之间区分性能的其中一个重要的方面,就是它附带的缓存的层级数,以及每层缓存的容量大小。
好,那这个就是我们的CPU里面的缓存结构。
那大家是否明白?
那么缓存从软件层面又是一个什么样的结构呢?
你可以把缓存理解成是一张Excel表格。
这个表格里面每一次我们能访问的实际上是这个表格的一行数据。
那这个一行数据是多长?
前面我给大家已经提示过了,每一行数据实际上是64个字节。
由此可见,其实我们的CPU每次能访问的数据量是比较小的。
它不像内存,可以一次传输一个数据块。
而缓存每次只能传一个缓存行,叫做CacheLine。
一个CacheLine只有64个字节。
好吧,大概是这样子的:
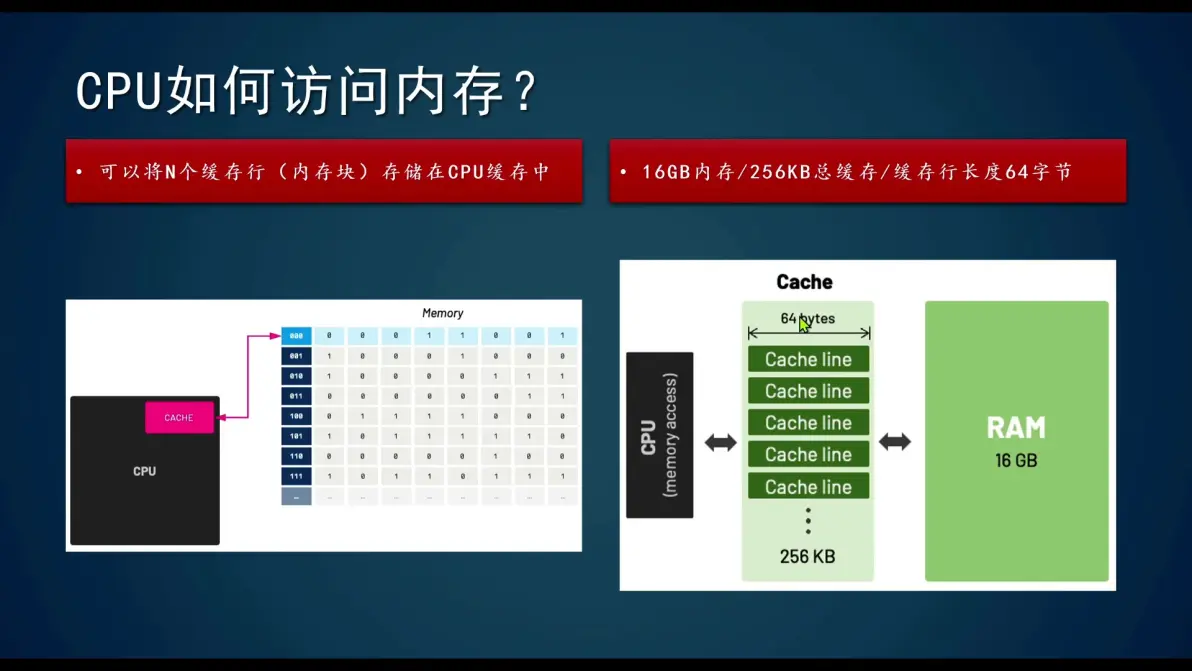
缓存行与内存关系图
比如说像右边是一个拥有16G内存的一个电脑,它的缓存总共有256K,每一个缓存行的长度是64个字节。
这个基本上是大多数现代的电脑的一个标配方式,当然缓存数量是越来越大的。
好,那这个是CPU如何访问我们的内存,其实是具体如何访问我们的缓存。
接着我们再看下面这个问题:假设CPU缓存行一个字是16字节,那么哪种方式访问数组更快?
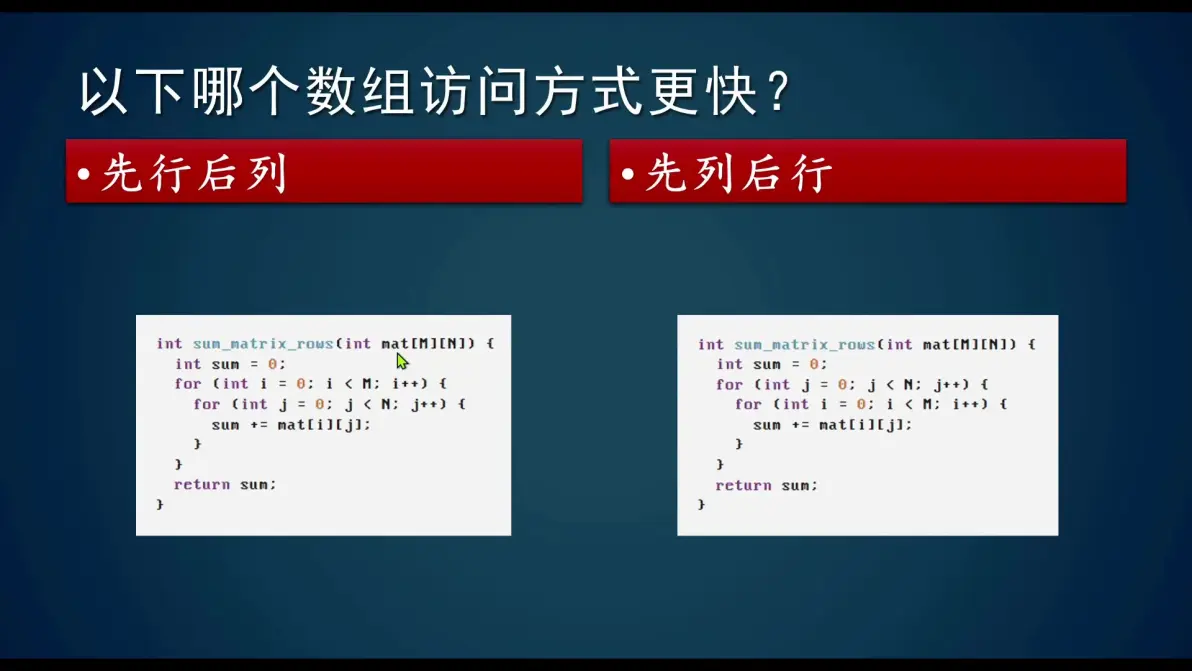
行列访问代码对比图
大家可以看到左边和右边的代码基本上是相似的。
他们都是传入一个数组,这个数组是我们游戏开发当中常见的一个矩阵数组,叫做 mat,它有M行N列。
我们在写这个for循环的时候,它有两种写法:
那么现在问题来了:两种数据访问方式,你觉得哪种方式快?
如果你选的是第二种,那恭喜你,答错了!🤣
为什么?——因为对于一个二维数组来说,它在内存里面是按照行连续的。
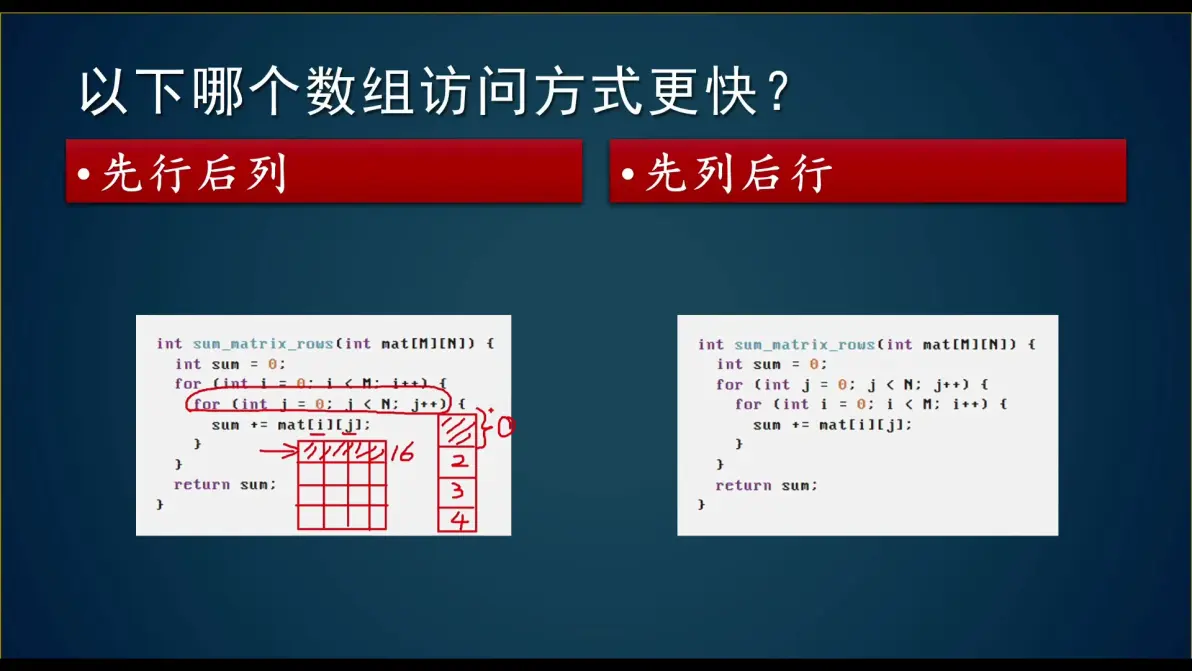
二维数组内存布局图
假设这是一个4行4列的二维数组,它有四行,每行四列。
这个时候在内存里面,数据肯定不可能是一个这种表格的形式,因为内存是一个线性的结构。
它会把我们的第一行放在我们内存的第一个区块里面,这是我们的第二行,这是我们的第三行,最后是我们的第四行。
所以,在这个CPU里面,它会把每一行的四个数、每个数的4个字节连续存放,所以说它总共是占连续的16个字节。
假设CPU缓存行一次能抓16个字节的数据,那么它会连续的把这16个字节的数据一次性的抓到我们的一个缓存行里面。
那这个时候它的访问效率是最高的。
也就是说,在这个程序里,CPU可以连续的访问第一行的第一列、第二列、第三列、第四列,它在同一个缓存行里面,一次性的被抓到我们的缓存里面去使用。
所以这种方式访问起来,效率会更高一些。
好,第二个问题,其实也是跟我们刚才讲的缓存有关系的。
我们在编写我们程序里的时候,都会使用到各种各样的结构体。
我们看下面这个问题:
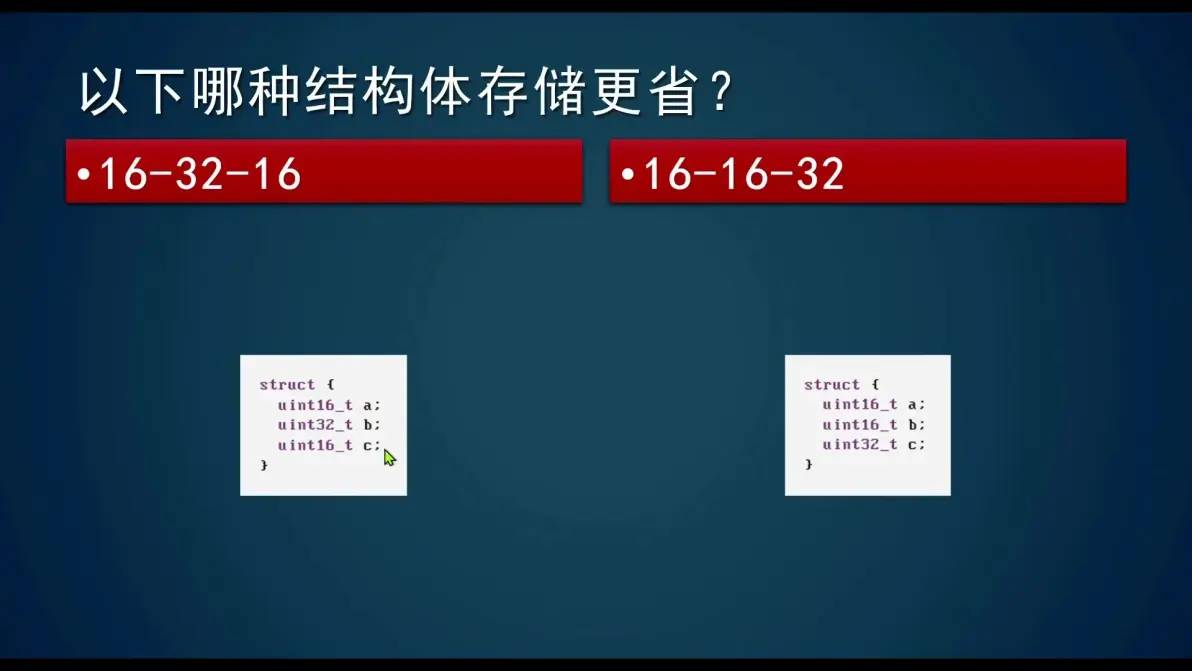
结构体内存对齐对比图
前面这个a是uint16,你可以把它看成是一个16位的整数,这个代码是用C语言写的。
底下这个b是一个32位的整数,
接着是c,它是一个16位的整数。
我们以不同方式排布这个结构体:
那么问题来了:是左边这种方式在存数据的时候更加节省存储空间,还是右边这种方式更加节省存储空间呢?
那这个问题我们缓存跟我们的CPU有什么关系?
其实你省的存储空间不仅仅是”内存空间“,还会省”缓存空间“,而且省了空间,CPU访问的效率也会更高!
在这里先留一页空白,大家可以结合我上面的”暗示“,想一想,直接把网页滚到讨论区写答案,回来再看答案😜
(提问空白开始)
(提问空白结束)
好,这里公布答案。
右边这种方式确实更省一点
这个就牵涉到内存对齐的问题。
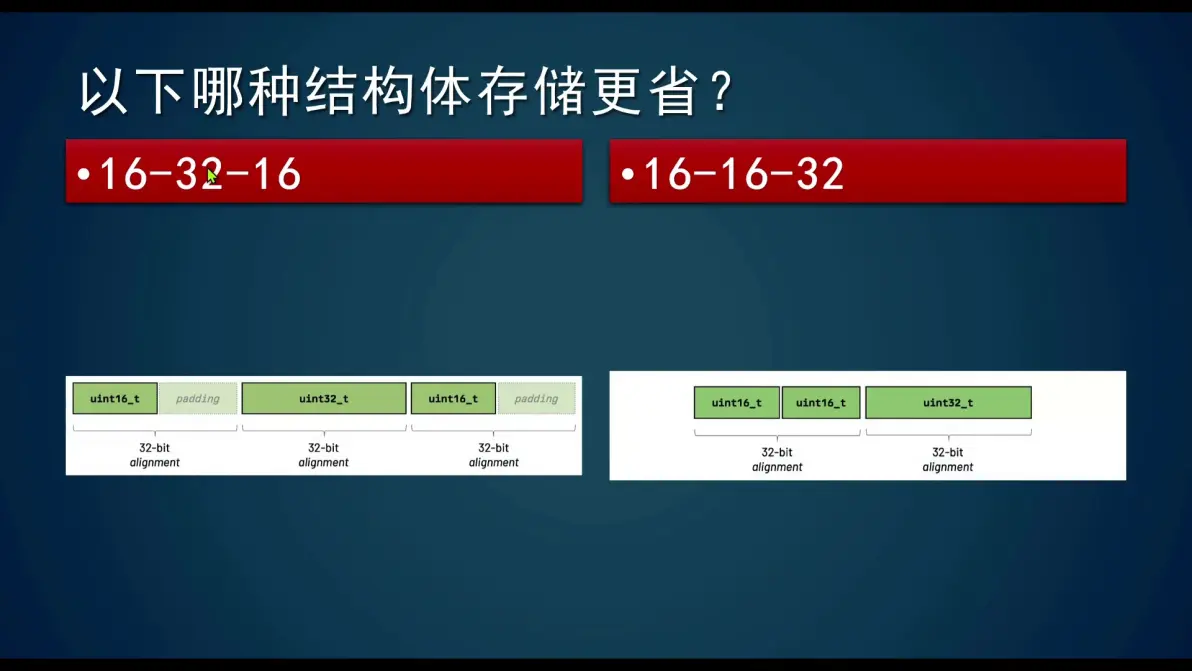
内存对齐原理图
我们来看一下,具体它在图形上呈现的是一个什么样的?
如果我是以16位,32位,16位的形式来存储三个字段,下面接的数据加起来是不是48个位?
所以说你在下面再访问数据的时候,就是从第49位开始去存数据了。
那这个时候好,你存进去可能是没有问题。
但是问题是在内存访问的时候,我们的内存能不能从第49位开始访问?
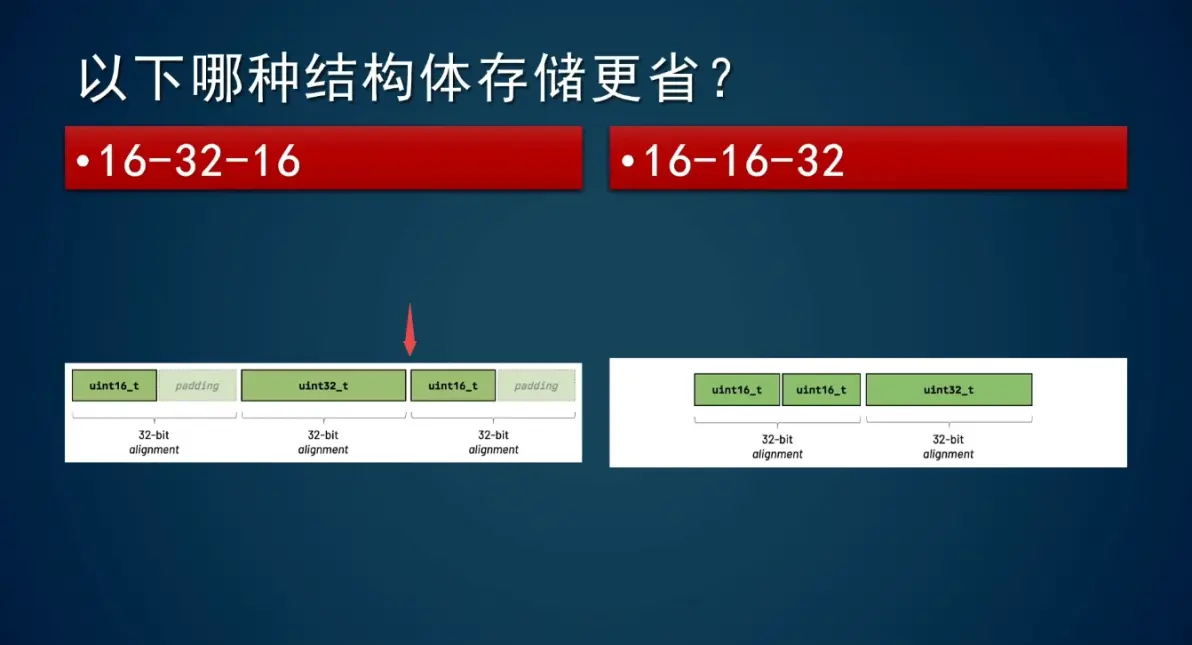
答案是可以,但是效率很低,因为它没有做到内存对齐。
内存对齐的意思是指,它要按照我们这个系统的一定的倍数来去存储数据。
为了严谨起见,在这里我们以32位对齐的系统为例(比如早期的32位的Windows系统)
那如果我们使用16,16,32的方式,两个16构成在一起是32位。
好,如果是32位对齐的,那么两个16位是不是可以构成一个32位?
那么,这个时候如果我要访问第一个16位的数据的时候,CPU就会把这两个16位的数据一次性抓出来,抓出来以后访问这个第一个16位。
如果我要访问第二个16位也是一样,CPU把这两个数据全部抓出来访问第二个。
如果我要访问第三个数据的时候,那CPU也是一样的,它只要访问第二个32位就行了。
但是如果是左边这种情况,如果你是没有做内存对齐,那么它的数据结构大概是这样子,从第17位到第48位,是存储我的第二个uint32的数据。
那这个时候我们的CPU要进行两次抓取,先抓第一个32位的后面16位的数据,再抓第二个32位的前面16位的数据。
那这个时候你想一下,本来我访问数据我只要一次抓取就可以,现在变成两次抓取,是不是很慢,好吧?
大家也可以尝试一下
怎么尝试呢?
上面我们不是写了个结构体吗?你不一定非要用C++写,如果你只会C#,你就写一个short类型,再写个int类型,再写个short类型。
(还是不会的话,可以参考我文末的”Unity全栈”项目)
你定义一个这样类型的一个结构体,定义完结构体以后,你用那个运算符叫做sizeof,sizeof,它的size是多少?
那么你会发现,因为我们的编译器自动会去做内存对齐的处理,
把它按照32个字节对齐。
因此,那么你这个16,32,16的内存布局,最后打印出来的size并不是这个64,而是前面一个32,中间再一个32,最后再一个32,一共是占了96个字节。
因为我讲的是一个CPU的问题,你只要用的是现代的这种CPU,它都会有这个问题。
甚至你用任何的编程语言,用任何的游戏引擎,用任何的操作系统,它都会有这个问题存在。
(如果觉得文字描述有点难懂,可以看我文末的视频讲解)
这个也是为什么我们的ECS,就是Unity最新的编程的架构,要采用ECS的原因。
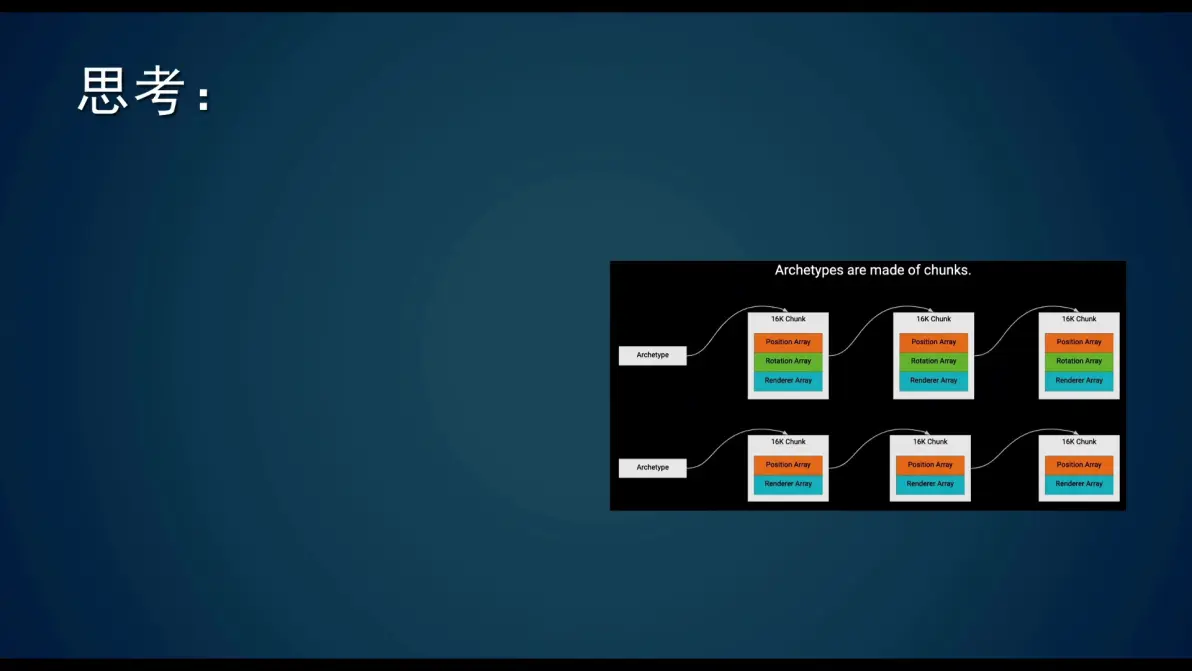
ECS架构示意图
因为ECS,它首先它采用的是结构体struct。
如果你使用class,每次new出来的内存,它散落在不连续的内存地址上,所以CPU访问效率很低。
如果使用ECS,它会把所有的这些对象数据以结构体的方式来去进行存储。
因为ECS要求你必须用Struct来组织数据。
那么Struct,它首先它是分配一块连续的内存。
由于数据连续,CPU在访问这些数据的时候效率更高。
因为它可以把这些连续的数据一次性的抓取到缓存里面。
这样就不需要再一级一级的先从一级缓存去抓数据,抓不到再从二级缓存去取……这样
当然,ECS本身是Unity DOTS技术栈的一部分,具体可以参考我的“主程进阶”项目
进一步来说,如果项目使用ECS,那需要对传统基于GameObject的项目进行完全重构吗?
这个也是大家很多人会问的一个问题。
比如说,我现在项目里面,我已经使用了Unity的GameObject来表示对象数据。
那么我的项目是不是要完全按照ECS的架构重新写一遍?
答案是:不需要!
那怎么去做呢?大家也可以关注一下我的”主程进阶“项目。
好,那这个是第一个问题。
前面我说过,我们一共有三个问题:
第一个:CPU如何访问内存?,
第二个:是操作系统如何管理内存?
第三个:Unity如何使用内存?
你只要把这三个问题搞清楚,就会理解很多内存管理底层做法产生的原因。
关于后面这两个问题,请大家保持关注,后续我会继续分享~
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文





 155-2731-8020




